
Innhold
Mer fra Datateam
Hvordan agentbasert AI endrer datarollene

Kategori: Datateam | Emneknagger: #datateam, #ai-agenter, #dataroller, #kompetanse, #upskilling, #juniorer
AI-agentene skriver mer av koden, men datateamene blir ikke mindre. Jobben flytter seg fra å bygge til å kvalitetssikre, forvalte konteksten og støtte forretningen, og det endrer hvem dere trenger.
Kort fortalt: AI-agentene skriver nå mye av koden i datateamene, men de fleste team venter å vokse eller holde seg like store. Jobben flytter seg fra å bygge til å kvalitetssikre det agentene lager, forvalte konteksten de jobber ut fra, og støtte forretningsbrukerne. Den kompetansen finnes ofte hos forretningsbrukerne eller blant erfarne utviklere. De fleste virksomheter må derfor lære opp egne folk og gi juniorene en ny vei inn i fagområdet.
Be en AI-agent om fjorårets inntekt per aktiv kunde, og du har SQL-en på sekunder. Agenten vet ikke at inntektstabellen teller europeiske refusjoner to ganger etter en halvferdig migrering fra Stripe. Den vet heller ikke at produkt og økonomi regner en kunde som aktiv etter hvert sitt tidsvindu. Svaret ser riktig ut. Men det er feil.
Eksemplene er hentet fra en tekst av Joe Reis, medforfatter av boka Fundamentals of Data Engineering. Han skriver at slik kunnskap sitter i hodet på folk som har avgjort slike spørsmål i årevis, og at de tar den med seg når de slutter.
Agentene gjør byggingen billig. De gjør det ikke billigere å forstå hva dataene betyr. De endrer også hvilken kompetanse datateamet trenger.
Trenger datateamet færre folk?
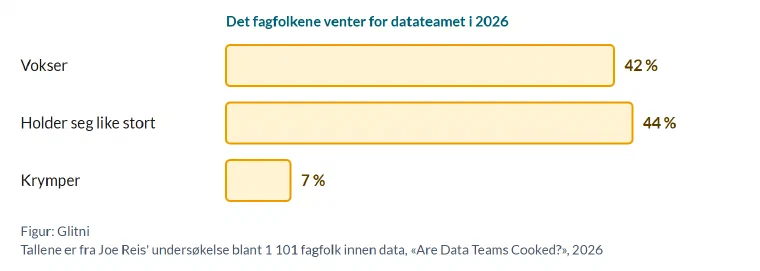
Undersøkelsene tyder ikke på det. Joe Reis spurte 1 101 fagfolk innen data i 2026. Av dem venter 42 prosent at teamet vokser, 44 prosent at det holder seg like stort, og bare 7 prosent at det krymper.
Hos oss er det jobbinnholdet som har endret seg. Vi anslår at våre data engineers i Glitni skrev kode selv rundt 70 prosent av tiden for to år siden. I dag er det rundt 15 prosent. Agentene skriver det meste av koden etter instruksjoner fra dem, og tiden går til avklaringer, arkitektur og beslutninger, og til å styre agentene. Vi har skrevet mer om hvordan vi bruker AI i kodearbeidet.
Vi tror mange virksomheter trenger færre utviklere totalt. Vanlige driftsoppgaver forsvinner, og det trengs ikke like mange nye applikasjoner. Samtidig vokser behovet for data, fordi agenter og automatiserte arbeidsprosesser trenger mer data og bedre kontekst. Datateamet kan derfor finne mange av de nye folkene sine i IT-avdelingen.
Hva endrer seg i arbeidshverdagen?
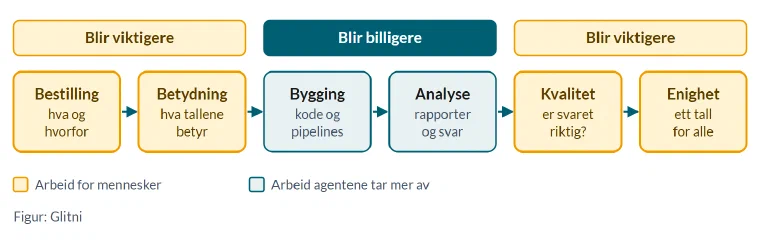
AI-agentene tar mest av arbeidet midt i kjeden, der en tydelig bestilling blir til kode med agenthjelp. En agent lager nå standard pipelines på minutter. Den kobler felt fra kilde til mål, oversetter mellom SQL-dialekter og dokumenterer det som alt finnes. Tre ferdigheter står igjen, og de blir viktigere:
Støtte forretningsbrukerne: å forstå hvordan beslutningene tas, og stille spørsmålene en rådgiver ville stilt. Hva skal tallet brukes til, og hva skjer hvis det er feil? Hvilken handling skal måltallet utløse? Er det verdt å bruke tid på?
Arkitektur og kvalitetssikring: å lage løsninger som kan forvaltes og endres, og sjekke at koden fra agentene er klar til produksjon.
Forvaltning av kontekst og harness: å holde orden på begrepene, definisjonene og hva agentene har lov til å gjøre. Harnesset er reglene, verktøyene og testene rundt agenten, og konteksten er det agenten må vite om virksomheten og dataene.
Under alle tre ligger jobben med å få folk enige om begrepene. Hver avdeling kan få sitt eget tall for aktive kunder på sekunder, og forskjellene kommer gjerne først fram i ledermøtet.
Julien Hurault skriver om data engineering i nyhetsbrevet Boring Data & AI. Han ser at de fleste feilene agentene gjør, ikke skyldes SQL-en. De skyldes at konteksten mangler: et nøkkeltall var uklart definert, eller en forretningsregel var aldri skrevet ned. Hver feil blir en ny regel agenten leser neste gang. Vi har skrevet mer om hvorfor metadata og ontologi er blitt grunnmuren AI leser fra.
Eksempel: en ny datakilde
Før bygde en data engineer innfasingen av en ny datakilde selv. Nå skriver hun reglene agenten følger: navnestandarden, testene hver dbt-modell skal ha, og hvilke tabeller agenten får lese. Agenten lager førsteutkastet, og hun går gjennom koden i en PR før den går i produksjon. Tiden hun sparer, bruker hun på å avklare med forretningen hva feltene betyr.
Kvalitetssikringen er der det oftest stopper opp. Undersøkelsen fra dbt Labs blant 363 fagfolk og ledere viser at 72 prosent prioriterer AI-assistert koding, mens bare 24 prosent prioriterer AI-assistert drift av pipelines, med testing og overvåking. Samtidig regner 71 prosent det blant de største bekymringene at feil eller oppdiktede svar når fram til de som bruker tallene. Vår tommelfingerregel er å måle to tall: hvor mye agentene lager, og hvor mye av det noen rekker å kvalitetssikre.
Hvor finner dere folkene?
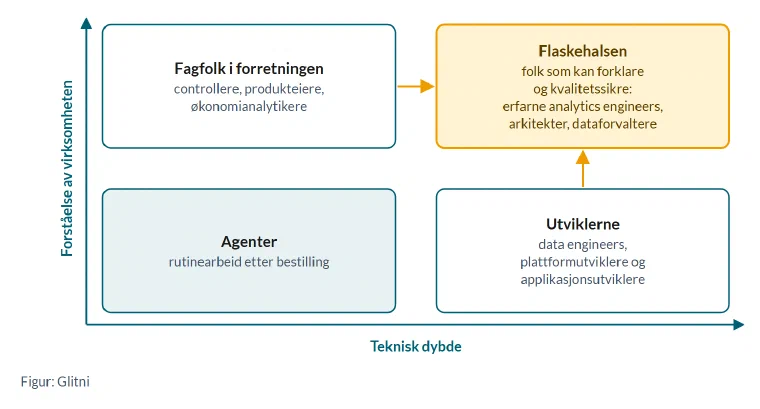
Det knappe er folk som både forstår virksomheten og har nok teknisk dybde til å kvalitetssikre det en agent har laget. I dag sitter de to halvdelene oftest i ulike personer. IBM spurte 1 700 datadirektører i 2025, og 77 prosent av dem sier at de sliter med å fylle viktige roller i datateamet.
Folkene kommer fra to kanter:
Fra forretningssiden: forretningsanalytikere, controllere og folk som har jobbet med rapporter og BI. De er nysgjerrige på problemet som skal løses og kjenner definisjonene, men må bygge teknisk bredde i integrasjoner, plattform, sikkerhet og tilganger. Forretningsforståelsen varierer fra svært god til mindre god.
Fra programvaresiden: applikasjonsutviklere med teknisk utdanning og bakgrunn. De er gode tekniske problemløsere, men må lære å stille forretningsspørsmål og forstå hva dataene skal brukes til.
Mange virksomheter har langt flere applikasjonsutviklere enn data engineers, og utviklerne kjenner ofte kildesystemene best, fordi de har bygget dem.
Eksempel: ordren uten leveringsdato
Utvikleren som bygde ordresystemet, vet hvorfor en ordre kan stå som levert uten leveringsdato. Controlleren vet hvorfor den samme ordren ikke skal telle i månedens omsetning. Agenten vet ingen av delene før en av dem har skrevet det ned.
Kartlegg derfor hvem som kjenner definisjonene, før dere kartlegger hvem som kan verktøyene. Reis peker på risikoen: folkene med denne kunnskapen blir ikke yngre, og de tar den med seg når de slutter.
Hvem trenger upskilling, og hvem trenger reskilling?
Upskilling betyr nye ferdigheter i samme rolle. Reskilling betyr å gå over i en ny rolle. Skillet går på om folk kan bygge det nye på det de er gode på i dag. En data engineer kan kode fra før, og det er nettopp det som trengs for å sjekke koden agentene skriver. En BI-utvikler lager mest rapporter, og det gjør agenten nå.
Sju roller trenger upskilling:
| Rolle | Fra | Til |
|---|---|---|
| Data engineer | Skriver hver pipeline selv | Bygger harnesset: standardene, testene og konteksten agentene jobber ut fra |
| Arkitekt | Tegner målbilder på avstand fra koden | Lager regler for hva agentene får gjøre, og bygger dem inn i løsningene |
| Produkteier | Bestiller analyser og rapporter fra datateamet | Ber agentene om analysen eller rapporten selv, og eier begrepene |
| Dataanalytiker | Forklarer hva som skjedde | Utreder hva som skjer hvis prisen endres, og eier definisjonene av nøkkeltallene |
| Dataforvalter | Skriver definisjoner folk slår opp i | Skriver begreper, regler og eksempler en agent kan bruke |
| Data scientist | Bygger egne modeller | Eksperimenterer og evaluerer svarene fra AI |
| Fagfolk i forretningen | Bestiller rapporter fra datateamet | Bestiller presist fra agentene og sjekker svarene innen eget fag |
Tre roller trenger reskilling:
| Rolle | Fra | Til |
|---|---|---|
| Rapport- og BI-utvikler | Lager rapporter | Bygger det semantiske laget, altså oppskriften på hvordan hvert nøkkeltall regnes ut |
| Utvikler i grafiske ETL-verktøy | Bygger pipelines med klikk i et grafisk verktøy | Bygger pipelines i kode, med versjonskontroll og tester |
| Applikasjonsutvikler | Bygger applikasjonene og kildesystemene | Blir data engineer og lærer dataforvaltning, modellering og forretningsspørsmålene |
Vi tror rollene som arkitekt og produkteier vokser, og at rollen som rapport- og BI-utvikler nesten forsvinner. Det trengs også færre data scientists, fordi ferdige språkmodeller løser mye av det egne modeller gjorde før. Utviklerne i grafiske ETL-verktøy må over til kode, fordi en agent har vanskelig for å lese, teste og endre en pipeline som bare finnes som klikk. Vi har skrevet mer om valget mellom grafiske verktøy og kode.
Skal dere lære opp egne, ansette eller leie inn?
Vi mener de flinke interne kan lære nye ting, og selv om kompetansen ikke er helt på plass, har de trolig konteksten. Rekruttering alene dekker sjelden behovet: IBM fant at bare 53 prosent av datadirektørene mener at rekrutteringen og arbeidet med å beholde folk gir dem kompetansen de trenger. Dere har alt ansatt folkene som kjenner definisjonene, og denne tilnærmingen er raskere å få verdi fra når agentene skriver mer av koden.
Folk lærer raskest med et strukturert program og erfarne kolleger ved siden av seg i det daglige arbeidet. Erfarne innleide bør bygge harnesset sammen med de ansatte, så kunnskapen blir igjen når oppdraget er over. Når dere ansetter, teller erfaring med definisjoner, testing og dataforvaltning mer enn kjennskap til ett bestemt verktøy.
Hva skjer med juniorene?
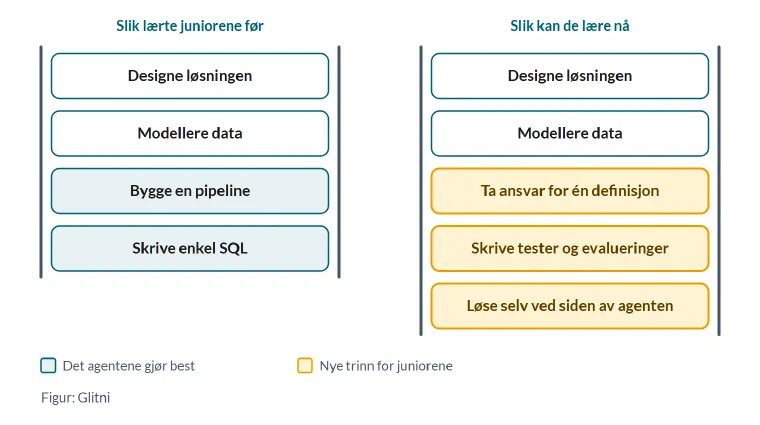
Agentene tar først oppgavene som ga juniorene effektiv læring: enkel SQL, standard pipelines og dokumentasjon. Forskere ved Stanford ser følgene i amerikanske lønnsdata. I juni 2026 lå sysselsettingen blant 22- til 25-åringer i de mest AI-utsatte yrkene rundt 19 prosent under nivået den ville hatt om den hadde fulgt jevnaldrende i yrker som er mindre utsatt. Det ser ut til at færre unge blir ansatt, ikke at flere mister jobben.
Folk må kunne gjøre jobben selv for å kvalitetssikre en agent, og den ferdigheten bygges ved å gjøre jobben selv først. Før fikk juniorene øvingen gratis. Nå må datalederen planlegge for å gi den. Bransjen får færre seniorer om ti år hvis den ansetter færre juniorer i dag.
Eksempel: juniorens første dbt-modell
En junior skal lage en dbt-modell for aktive kunder per måned. Hun skriver SQL-en selv først, ber så agenten om det samme og går gjennom forskjellen med en senior. Neste steg er å skrive testene som fanger feilene agenten gjorde. Etter noen måneder eier hun definisjonen av aktiv kunde, fra kilden til rapporten.
Hvor bør en dataleder begynne?
Begynn med oppgavene. Del hver rolle i oppgaver, og spør om en agent kan gjøre oppgaven med god nok kontekst. Svaret viser hvor tiden blir frigjort, hvor kvalitetssikringen må bygges opp, og hvem som trenger upskilling eller reskilling.
Norske virksomheter har så vidt begynt. I Navs bedriftsundersøkelse for 2026 svarte 53 prosent at de bruker kunstig intelligens, men bare 26 prosent av dem bruker den til dataanalyse og prognoser. Datalederne har altså tid til å planlegge rollene før agentene er overalt i datateamet.
- Finn folkene som kjenner definisjonene. Mange av dem sitter utenfor datateamet. Få kunnskapen deres skrevet ned der agentene kan lese den.
- Lag en plan per rolle. Avgjør hvem som trenger upskilling og hvem som trenger reskilling, og sett av tid til det. Modenhet bygges ikke i restkapasiteten.
- Ansett juniorer med vilje, og gi dem oppgaver de løser selv ved siden av agenten.
En test: Spør hvem i virksomheten som kan forklare hvorfor to rapporter viser forskjellige tall for aktive kunder. Svaret viser hvem dere trenger mest, og hvor de sitter i dag.
Vil dere gå gjennom rollene i datateamet sammen med oss? Send oss en melding.
Vanlige spørsmål om agentbasert AI og datarollene
Trenger datateamet færre folk når AI-agentene skriver koden? Undersøkelsene tyder ikke på det. Joe Reis spurte 1 101 fagfolk innen data i 2026. Av dem venter 42 prosent at teamet vokser, og 44 prosent at det holder seg like stort. Agentene endrer jobben: mindre bygging, og mer kvalitetssikring, forvaltning av konteksten og støtte til forretningen.
Hvilke dataroller blir viktigere med agentbasert AI? Rollene som kombinerer forståelse av virksomheten med nok teknisk dybde til å kvalitetssikre det agentene lager. Vi tror produkteiere, arkitekter og dataforvaltere vokser, sammen med erfarne analytics engineers og analytikere som eier definisjonene av nøkkeltallene. Data engineers bygger harnesset agentene jobber i.
Hva er forskjellen på upskilling og reskilling? Upskilling betyr nye ferdigheter i samme rolle, som når en data engineer går fra å skrive hver pipeline selv til å bygge harnesset agentene jobber i. Reskilling betyr å gå over i en ny rolle, som når en BI-utvikler begynner å bygge det semantiske laget, eller en applikasjonsutvikler blir data engineer.
Bør vi lære opp egne folk eller ansette nye? Vi mener de flinke interne kan lære nye ting. IBM spurte 1 700 datadirektører i 2025, og bare 53 prosent mener at rekrutteringen og arbeidet med å beholde folk gir dem kompetansen de trenger. Egne folk kjenner definisjonene, og de lærer raskest med et strukturert program og erfarne kolleger ved siden av.
Hvordan kan juniorer lære faget når agentene tar rutineoppgavene? Datalederen må legge inn øvingen med vilje. Juniorer kan løse oppgaven selv ved siden av agenten og gå gjennom forskjellen med en senior. Deretter kan de skrive testene og ta ansvar for én definisjon fra kilden til rapporten.
Kilder
- Joe Reis: Are Data Teams Cooked?, Joe Reis på Substack, 6. september 2026.
- dbt Labs: New dbt Labs Report Finds AI-driven Acceleration is Outpacing Trust and Governance, om rapporten State of Analytics Engineering 2026, 14. april 2026.
- Julien Hurault: The 10x Data Team = The Markdown Team, Boring Data & AI, 24. april 2026.
- IBM Institute for Business Value: IBM Study: Chief Data Officers Redefine Strategies as AI Ambitions Outpace Readiness, pressemelding om undersøkelsen blant 1 700 datadirektører, 13. november 2025.
- Erik Brynjolfsson, Bharat Chandar og Ruyu Chen: No Widespread Displacement, but the AI Employment Gap for Young Workers Has Widened to 19%, om revisjonen av «Canaries in the Coal Mine? Six Facts About the Recent Employment Effects of Artificial Intelligence», Stanford Digital Economy Lab, 12. august 2026.
- Nav: Bedriftsundersøkelsen 2026, Nav-rapport 2026: 2, mai 2026.