
Innhold
Apache Ossie viser hvor nøkkeltallene er definert

Kategori: Data Engineering | Emneknagger: #apache ossie, #open semantic interchange, #semantisk lag, #power bi, #datakatalog, #ontologi
Vi prøvde den åpne standarden på et eksempel med forsinkede flyavganger. Den gir et godt kart over definisjonene du alt har, men det er lang vei før nøkkeltallene kan flyttes trygt mellom verktøyene.
Artikkelen bygger på interndagen vår 7. oktober, der vi gikk gjennom spesifikasjonen og prøvde konverteren for Power BI.
Kort fortalt: Apache Ossie, tidligere Open Semantic Interchange (OSI), er en åpen standard for å beskrive datasett, begreper og nøkkeltall i YAML, slik at definisjonene kan flyttes mellom BI-verktøy, dataplattformer og AI-agenter. Standarden regner ingenting ut selv, og uttrykkene lar seg ikke alltid oversette mellom verktøyene. I dag er den mest nyttig som et kart over definisjonene du alt har, og som grunnlag for opprydding og migrering.
Hvor mye er avgangene på en flyrute forsinket i snitt? Spør tre verktøy, og du kan få tre svar. Ett regner innstilte avganger som null minutter forsinket, ett holder dem utenfor, og ett tar snittet per dag før det tar snittet for hele måneden. Alle tre formlene ser riktige ut, og ingen av verktøyene melder feil.
Hos de fleste virksomhetene vi jobber med, gjelder det samme for aktiv kunde, omsetning og leveringsgrad. Nøkkeltallene er definert i Power BI, i dbt, i et regneark hos økonomi og nå også i instruksjonene til en AI-agent. Prosjektet bak Apache Ossie bruker månedlige aktive brukere som eksempel. Begrepet er definert ulikt i CRM, datavarehus og BI-verktøy, og verken en analytiker eller en agent skal måtte gjette hvilken definisjon som gjelder.
Ossie skal løse dette. Snowflake startet arbeidet i september 2025 under navnet Open Semantic Interchange, sammen med blant andre Salesforce, dbt Labs, BlackRock og RelationalAI. I juni i år ble prosjektet tatt opp i Apache-inkubatoren og fikk nytt navn. Standarden er et åpent format for å beskrive datasett, felt, relasjoner og nøkkeltall, slik at definisjonene kan flyttes mellom verktøy i stedet for å være låst i ett.
På interndagen vår 7. oktober satte vi oss ned med spesifikasjonen og flyeksemplet som følger med på GitHub, for å se hva standarden gjør med problemet over. Rommet var enig om at bruksområdet er tydelig, men at det er lang vei før standarden virker i praksis. I dag er Ossie mest nyttig som et kart over definisjonene du alt har, ikke som en felles motor som får alle verktøyene til å regne likt.
Hva er Apache Ossie?
Apache Ossie er en åpen spesifikasjon for semantiske lag og ontologier. Den beskriver forretningsbegreper, nøkkeltall, dimensjoner og relasjonene mellom dem i et format som ingen leverandør eier, og som BI-verktøy, spørremotorer og AI-agenter kan lese og skrive. Prosjektet er i Apache-inkubatoren, og spesifikasjonen er fortsatt et utkast.
Kunngjøringen på prosjektets nettsted begrunner valget av Apache med at en standard for hele bransjen ikke kan kontrolleres av én aktør. Under inkubasjonen stemmes endringer i spesifikasjonen fram i åpne kanaler, og retten til å endre koden opparbeides gjennom bidrag, ikke gjennom arbeidsgiver. Ifølge prosjektet har over 50 organisasjoner sluttet seg til, mot 17 ved lanseringen. Bidragsytere fra blant andre Snowflake, Databricks, dbt Labs, Salesforce, Dremio og GoodData har levert over 100 commits. dbt Labs gjorde metrikkmotoren MetricFlow til åpen kildekode i oktober 2025, med arbeidet i Ossie som begrunnelse.
Bredden er reell, men modenheten er lav. Spesifikasjonen har versjon 0.2.0.dev0 og sier selv at den ikke skal brukes i produksjon, og siste utgitte versjon er 0.1.1 fra desember 2025. Den som tar standarden i bruk nå, må regne med at formatet endrer seg.
Flyeksemplet gjennom fire lag
Flyeksemplet i repoet viser hvordan Ossie er tenkt brukt, i fire lag: en ontologi med begrepene, en semantisk modell med datasettene, en mapping som kobler de to, og tabellene i databasen. De tre første er hver sin fil, og eksemplet viser at standarden er mer enn et skjema for nøkkeltall.
Ontologien beskriver det som finnes i forretningen: tolv typer ting, som Flight, Carrier, Aircraft, Airport og Route, og 32 verdityper, som minutter, miles og kodene som identifiserer et flyselskap. Her står også relasjonene og hvor mange av hver det kan være, for eksempel at et flyselskap har nøyaktig én kode, og at en rute har en avgangs- og en ankomstflyplass. En i gruppa kalte ontologien «katalogmat». Den inneholder begrepene og ikke et ord om tabeller.
Den semantiske modellen beskriver det som ligger i databasen: seks datasett med til sammen 51 felt, ett datasett per tabell. Mappingen kobler de to, og sier for eksempel at flyselskapets kode hentes fra kolonnen code i tabellen CARRIER. Fordi begrepene ikke kjenner kolonnene, kan samme ontologi kobles til en annen database. Skillet mellom begrepene og tabellene, og koblingen mellom dem, avgjør også om en AI-agent forstår hva dataene betyr. Det har vi skrevet om i Metadata og ontologi har blitt fundamentet AI leser fra.
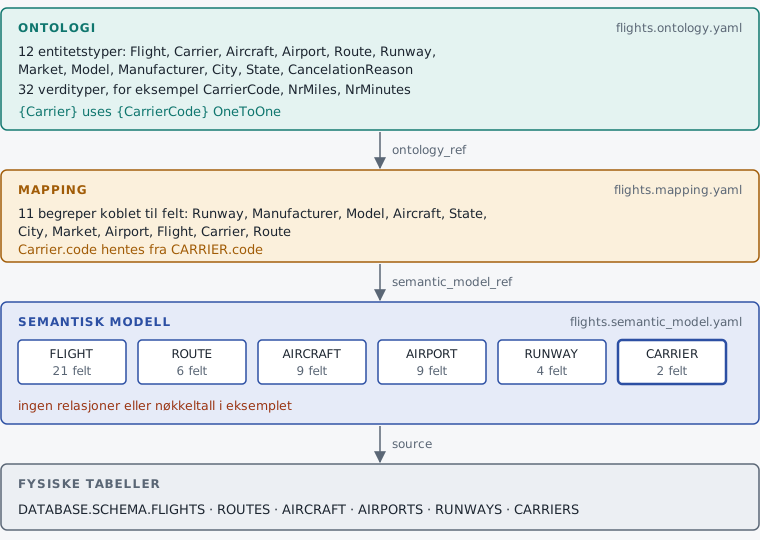
Legg merke til det som mangler. Den semantiske modellen i eksemplet har ingen relasjoner og ingen nøkkeltall, bare datasett og felt. Spesifikasjonen har plass til begge deler, og til feltet ai_context med synonymer og eksempelspørsmål for agenter, men flyeksemplet bruker dem ikke. Meningen ligger i ontologien.
Hvor regnes nøkkeltallet ut?
Ossie regner ingenting ut selv. Standarden sier hvor definisjonen av et nøkkeltall står og hvilket språk uttrykket er skrevet i, og verktøyet som bruker modellen, gjør utregningen. Et nøkkeltall er et aggregeringsuttrykk, for eksempel en sum eller et snitt, skrevet i et uttrykksspråk som er et begrenset utvalg av ANSI SQL.
Uttrykksspråket heter OSSIE_SQL_2026 og tillater ikke SELECT, FROM, JOIN, GROUP BY eller WHERE. Koblingene mellom tabellene overlates til verktøyet, og grupperingen styres av en egen utvidelse som ligger utenfor kjernen av spesifikasjonen. Et uttrykk kan også skrives i dialekten til et bestemt verktøy, som Snowflake, Databricks eller DAX.
Reaksjonen i gruppa var at poenget da forsvinner. Låser ikke standarden hvordan snittet grupperes, kan tre verktøy fortsatt gi tre svar på forsinkelsen. Så fant vi derived_by i ontologien. Der er gjennomsnittlig avgangsforsinkelse per rute definert slik:
Delay == AVG[Flight.departure_delay WHERE Flight.route(Route) GROUP BY Route]
Definisjonen er presis, og den som kjenner forretningen, kan lese den. Men den er skrevet i relasjonslogikk og ikke i SQL, og vi fant ingen konverter i repoet som gjør derived_by om til en spørring som kan kjøres. Definisjonen beskriver tallet, og et verktøy må fortsatt regne det ut på sin måte. Ossie gjør uenigheten mellom verktøyene synlig, men fjerner den ikke.
Snowflake ser det samme hullet. I kunngjøringen om Apache-navnet skriver selskapet at det vil foreslå et eget uttrykksspråk, mer avansert logikk for nøkkeltall og en felles spesifikasjon for spørringer som alle motorer kan støtte.
Fungerer Ossie med Power BI?
Delvis. Microsoft stilte seg bak Ossie i slutten av september, og konverteren for Power BI og Fabric gjør en Ossie-fil om til en semantisk modell og tilbake. Men mål fra Power BI blir stående i DAX, bare et smalt utvalg SQL-uttrykk oversettes, og Chris Webb hos Microsoft mener at folk må definere nøkkeltallene i Power BI.
For de fleste norske virksomheter er dette det viktigste spørsmålet. Microsoft skrev på Power BI-bloggen at selskapet stiller seg bak Ossie, i nært samarbeid med Snowflake, og ifølge Snowflake er ingeniører fra Microsoft med i arbeidet. Konverteren virker uten kobling til tjenestene. Et mål fra Power BI blir et nøkkeltall med uttrykket i DAX, og bare et smalt utvalg SQL-uttrykk oversettes til DAX. Dokumentasjonen forklarer hvorfor: DAX regner ut aggregater innenfor en filterkontekst som ikke finnes i SQL.
Et uttrykk konverteren ikke kan oversette, blir et tomt mål med en advarsel. En gjettet formel ville vært verre, skriver forfatterne. En typekonvertering som forsvinner eller et aggregat som fordeles over en kobling, gir en modell som lastes og returnerer et tall, bare et feil tall. Det er et fornuftig valg. Men det betyr at en definisjon i SQL og en i DAX kan stå side om side i samme fil, uten at noe i standarden kan si om de gir samme tall.
Da vi prøvde konverteren for Power BI på interndagen, virket den umoden, og den håndterte relasjoner dårlig.
Chris Webb sitter i Microsofts kunderådgivningsteam for Fabric. I april skrev han at Power BI ikke kommer til å fungere fullt ut med semantiske modeller fra andre leverandører. En semantisk modell i Power BI forutsetter at det er der alle nøkkeltallene regnes ut. Er et nøkkeltall definert et annet sted, kan ikke Power BI garantere riktige delsummer og totaler. Han skriver at det er mulig og støttet å synkronisere nøkkeltall fra et annet semantisk lag inn i Power BI. Rådet hans er likevel å definere alle nøkkeltallene i den semantiske modellen i Power BI.
Microsoft skriver at selskapet vil arbeide for at DAX blir et språk standarden anerkjenner, og for bedre støtte for ontologier. Da kan en definisjon fra Power BI stå i en Ossie-fil uten å oversettes, men den kan fortsatt bare regnes ut av verktøy som forstår DAX. Formatet blir felles, mens utregningen blir der definisjonen er skrevet, og det stemmer med rådet Webb ga i april.
Hva konverterne flytter, og hva de mister
Konverterne flytter datasett og felt mellom verktøyene, men nøkkeltallene bare delvis. Ossie har ikke noe som tilsvarer alle typene nøkkeltall i dbt og Power BI, og det som ikke har en plass i standarden, faller bort på veien. Tabellen under bygger på dokumentasjonen til konverterne, ikke på en kjøring mot en ekte modell.
Simon Späti, forfatteren av boka Patterns of Data Engineering, skrev i september at en modell i standarden enkelt kan kartlegges til ethvert semantisk lag. Da slipper vi en egen YAML-dialekt for hvert verktøy, slik LookML, Cube, dbt og Snowflake har i dag. For datasett og felt stemmer det, men for nøkkeltallene viser konverterne et annet bilde.
| Konverter | Retning | Det du må passe på |
|---|---|---|
| Power BI og Fabric | Begge veier | Mål i DAX blir stående i DAX, og SQL-uttrykk utenfor et smalt utvalg blir tomme mål med advarsel. Inaktive relasjoner og mange-til-mange-relasjoner blir ikke med |
| dbt | Begge veier | Konverteringsrater i en trakt og nøkkeltall merket som private blir ikke med |
| Apache Polaris | Begge veier | Bare tabeller, kolonner og typer blir med |
| Snowflake | Lese og skrive, i forhåndsversjon | Det som bare finnes i Snowflake, legges i egne utvidelser |
En migrering gjennom standarden mister det som ligger utenfor fellesnevneren, og advarslene fra konverterne er en del av kontrollen.
Der Ossie har en jobb å gjøre i dag
Det tydeligste bruksområdet er oversikt. Les ut alle de semantiske modellene i Power BI gjennom API-et, gjør dem om til Ossie, med målene i DAX, og legg dem i et repo. Da ser du hvor et begrep som aktiv kunde er definert på tvers av ti eller hundre modeller, og hvor definisjonene spriker.
Oversikten gir grunnlag for opprydding og migrering. Ser du fem varianter av samme nøkkeltall, kan forretningen velge én. Logikken kan også flyttes fra Power BI ned i plattformen, der agentene kan bruke den. Hos en kunde med Databricks og Power BI, der en dataagent skal svare ved siden av rapportene, kan en felles definisjon i samme repo sikre at agenten og rapportene regner likt. En agent kan også bruke mappingen til å lete etter begreper som overlapper, så lenge noen holder mappingen ved like.
Leverandørene har begynt å bygge veien. Snowflake kan i dag lese en semantisk visning og skrive den ut som en Ossie-fil, og bygge en semantisk visning fra en Ossie-fil, foreløpig som forhåndsversjon. Funksjoner som bare finnes i Snowflake, legges i egne utvidelser, slik at definisjonen overlever turen gjennom andre verktøy. Tanken er den samme som i deklarative dataplattformer: du beskriver hva du vil ha i en fil, og verktøyet gjør jobben.
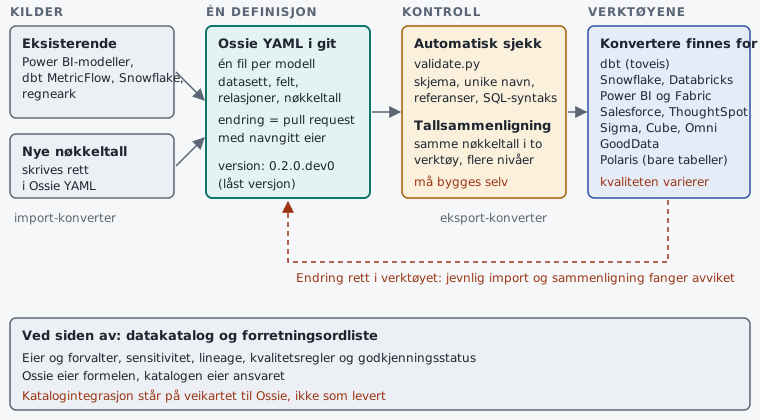
Figuren viser hvordan vi ville innført standarden hos en kunde i dag, i seks steg:
- Begynn med fem til ti nøkkeltall som avdelingene er uenige om, og skriv ned hvor hvert er definert og hvilke tall det gir.
- Importer fra verktøyet som brukes mest, rett opp for hånd og legg filene i git.
- Gi hver fil en navngitt eier, og sjekk hver endring automatisk. Repoet til Ossie har et valideringsskript som sjekker skjema, unike navn, referanser og SQL-syntaks.
- Eksporter til to verktøy og regn ut samme nøkkeltall på noen detaljnivåer.
- Forklar eller fjern avvikene før noen stoler på at tallene er like.
- Koble først da nøkkeltallene til begrepene i datakatalogen, og la agentene bruke beskrivelsene og synonymene i modellen.
Den stiplede linjen viser avviket du må fange når noen endrer et nøkkeltall rett i verktøyet og går forbi git. Konverterne for import finnes, men jobben som sammenligner, må du bygge selv.
Datakatalogen eier det Ossie mangler
Ossie har ingen felt for eier, forvalter, domene, klassifisering, lineage eller kvalitetsregler. Standarden beskriver hva et begrep regnes som, men ikke hvem som svarer for det eller hvor gode dataene bak er. Det er oppgaven til datakatalogen og forretningsordlista, det mange kaller business glossary. Hvordan en katalog kan bygges opp, har vi vist i dataproduktguiden.
Jochen Christ, medgründer og teknologidirektør i Entropy Data, bidrar i arbeidsgruppen for ontologien i Ossie. Han plasserer standarden i tre nivåer. Øverst er ontologien med begrepene, relasjonene og reglene. I midten er dataproduktene, datakontraktene og de semantiske modellene i BI-verktøyene, som viser opp til begrepene og ned til tabellene. Nederst er tabellene og kolonnene. Ossie beskriver de to øverste nivåene, mens dataprodukter og datakontrakter har egne åpne standarder fra Bitol.
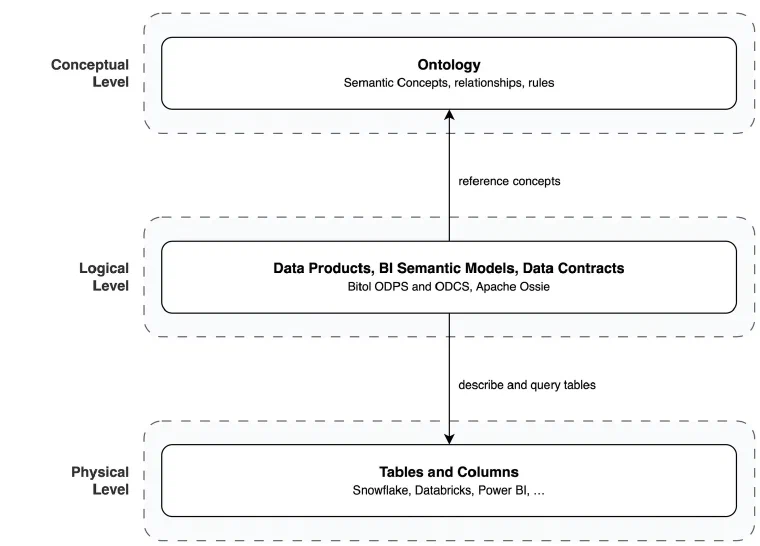
I den modellen er det dataproduktet som har en eier og leverer dataene, og datakontrakten som beskriver skjema, kvalitetsregler og bruksvilkår. Hvert felt i kontrakten kan vise til begrepet i ontologien det står for. Med den arbeidsdelingen trenger ikke Ossie egne felt for eier og kvalitet, men noen må holde koblingen mellom kontrakten og begrepet ved like.
Overlappet er størst i den forretningsnære delen. En oppføring i ordlista er et begrep med definisjon, eier og status. Et nøkkeltall i Ossie har navn, beskrivelse og synonymer, og i tillegg et uttrykk som kan kjøres. Arbeidsdelingen blir derfor at ordlista eier begrepet og ansvaret, mens Ossie eier utregningen. Koblingen mellom dem må du bygge selv i dag, for integrasjon med katalogen står på veikartet til prosjektet og er ikke levert.
Gruppa var også skeptisk til datakatalogen som idé, fordi få orker å holde den ved like. Utvides Ossie med eierskap og forvaltning, blir standarden svært bred. Vi har skrevet om hva uklart dataeierskap koster, og den kostnaden blir ikke mindre av at definisjonene ligger i YAML.
Innvendingene som står igjen
Fire innvendinger sto igjen etter interndagen, og alle handler om det standarden ikke løser: definisjonen ligger løsrevet fra dataene, eier og prosess mangler, et filformat strukturerer ikke forretningens kunnskap, og arbeidet er ungt. Ingen av dem er en grunn til å la være å prøve standarden, men de avgjør hvor mye du kan stole på en Ossie-fil alene.
Definisjonen ligger løsrevet fra dataene. I dbt testes en relasjon mot dataene hver gang modellen bygges. I Ossie står det bare at relasjonen gjelder, og ingen ser om den stemmer før noen regner ut tallet. Datakontrakter løser det samme problemet for skjema og kvalitet, med forventninger som testes.
Eier og prosess mangler. Ella Pham skrev i 2024 i nyhetsbrevet Data & Beyond at et semantisk lag uten eiere av nøkkeltallene virker mot sin hensikt. Brukerne diskuterer fortsatt hva tallene betyr, men kan ikke lenger rette dem selv. Silja Märdla beskriver det samme fra et prosjekt med to konkurrerende semantiske lag. Det vanskeligste var sjelden å definere nøkkeltallene, men å få nok enighet på tvers av teamene til at definisjonene ble stolt på og brukt i flere verktøy.
Forretningen må strukturere kunnskapen sin, og det gjør ikke et filformat. Klarer en virksomhet det, ville en markdown-fil med begrepene og hvordan de henger sammen, vært nesten like nyttig som en YAML-fil. Modellering ovenfra, der man starter med hvordan forretningen virker, skjer sjelden, og rollen som informasjonsarkitekt er stort sett borte. Et foredrag på Big Data London i høst minnet om at det semantiske laget ikke er nytt. SAP BusinessObjects hadde Universe, og Cognos hadde sitt eget lag. Simon Späti daterer ideen til 1991, da Business Objects patenterte den. Det nye er at laget skal brukes av agenter, i et omfang ingen kan følge opp for hånd. Foredraget trakk fram datamodellering som nøkkelkompetansen, og det er vi enige i.
Arbeidet er ungt. På Big Data London var semantisk lag og kontekst hovedtemaet, uten en felles forståelse av hva et semantisk lag er. En av hovedtalerne viste et lysbilde med en rekke konkurrerende spesifikasjoner. I en samtale på en av standene hørte vi at folk kommer og går i arbeidet med Ossie, og at få har det som heltidsjobb. Søknaden til Apache sier selv at kjerneutviklerne kommer fra tre selskaper, Snowflake, Dremio og dbt Labs, og kaller det et avgjørende mål for inkubasjonen å få med flere. Samtidig er repoet i bevegelse: det kom nye commits både 7. og 8. oktober, og arbeidsgruppene for nøkkeltallspråk, katalog og ontologi har egne ledere.
En annen gruppe syntes det var vanskelig å se hvilket problem standarden løser, og mente spesifikasjonen ikke sier tydelig hvordan to tabeller kobles, eller hvilken kardinalitet koblingen har. Svaret står der, men det er lett å gå glipp av. En relasjon i kjernen av spesifikasjonen er en fremmednøkkel fra mange-siden til én-siden, og om den er mange-til-én eller én-til-én, avgjøres av primærnøkkelen. I flyeksemplet står kardinaliteten i ontologien, som er et eget format utenfor kjernen, mens den semantiske modellen ikke har relasjoner. Den som vil forstå koblingene, må lese to filer i to formater.
Kardinaliteten avgjør om tallet blir riktig. Hao Wu i PuppyGraph, som selv lager eksport til Ossie, bruker en ordre på 100 dollar med tre ordrelinjer som eksempel: kobles ordretotalen til hver linje og summeres, blir svaret 300 dollar. At relasjonen står i modellen, beviser ikke at verktøyet som regner, håndterer den riktig.
To ting om koblingene kan spesifikasjonen ikke si. Den har ingen plass til typen kobling, altså om rader uten treff i den andre tabellen skal være med eller holdes utenfor, så det avgjør verktøyet som regner. Den kan heller ikke si hvilken kobling et nøkkeltall skal bruke når to felt viser til samme tabell, som ordredato og leveringsdato mot samme datotabell. I Power BI er svaret en inaktiv relasjon som målet slår på når det trenger den. Konverteren for Power BI melder at Ossie ikke har noe som tilsvarer det, og tar ikke relasjonen med.
Når Ossie er verdt tiden
Ossie er verdt å se på nå hvis dere har mange semantiske modeller i Power BI eller andre BI-verktøy og ikke vet hvor nøkkeltallene er definert, hvis logikk skal flyttes ned i plattformen, eller hvis en agent og rapportene skal svare likt. Da er standarden et godt format for oversikten, og konverterne gir et første utkast.
Standarden er mindre nyttig hvis dere har ett BI-verktøy og ett sted nøkkeltallene defineres, hvis ingen eier nøkkeltallene, eller hvis dere venter at den skal få alle verktøy til å regne likt. Den erstatter heller ikke datakatalogen.
Hvor lang tid modningen tar, vet ingen. Søknaden bruker Apache Polaris, katalogen for Iceberg-tabeller, som forbilde for å få med flere bidragsytere. Polaris kom inn i inkubatoren i august 2024 og ble et selvstendig Apache-prosjekt i februar 2026, halvannet år senere. Alex Merced i Dremio, som selv sier at han ikke er nøytral, råder til å lese Ossie som en retning å følge og bidra til, ikke som et ferdig format å satse en migrering på dette kvartalet.
Slår standarden gjennom, blir regnestykket et annet. Kan de store verktøyene lese og skrive samme fil, slik mange motorer i dag leser tabeller i Apache Iceberg, kan en virksomhet bytte verktøy uten å bygge forretningslogikken opp igjen. Da lønner det seg også mer for leverandørene å lage verktøy rundt én felles standard enn rundt formatet til én plattform.
Tar dere den i bruk, lås versjonen av både spesifikasjonen og konverterne. Kjør konverteren for Power BI med flagget --strict, så den feiler i stedet for å miste noe uten å si fra. Regn så ut samme nøkkeltall i to verktøy før dere stoler på at de er like.
Spørsmålene vi tar med oss
Ossie kan ikke fortelle deg hvilket av de tre svarene på forsinkelsen som er riktig. Den kan vise at det finnes tre definisjoner, hvor de står, og hva som skiller dem. Står de i ulike språk, som SQL og DAX, må noen regne ut tallet i begge verktøyene og sammenligne. Valget er forretningens, slik det alltid har vært.
To spørsmål fra rommet sto igjen uten svar. Er et stjerneskjema med gode navn i seg selv et semantisk lag, eller må det ligge nøkkeltall oppå? Og kan agenter som svarer på naturlig språk, bli veien ut av Power BI for virksomheter der Copilot ikke svarer godt nok?
Juan Sequeda, som arbeider med datastrategi i ServiceNow, har stilt to spørsmål om kontekstlaget som agentene skal lese fra, og de gjelder like mye her: hvor skal det ligge, og hvem eier det? Alle plattformene svarer at det skal ligge hos dem, og har det ingen eier, forfaller det.
Vil dere se hvor nøkkeltallene er definert i dag, er de semantiske modellene i Power BI et godt sted å begynne. Send oss en melding, så viser vi hvordan en slik kartlegging kan se ut.
Vanlige spørsmål om Apache Ossie
Hva er Apache Ossie? Apache Ossie, tidligere Open Semantic Interchange, er en åpen spesifikasjon for å beskrive semantiske modeller og ontologier i YAML: datasett, felt, relasjoner, nøkkeltall og forretningsbegreper. Målet er at definisjonene kan flyttes mellom BI-verktøy, dataplattformer og AI-agenter. Prosjektet er i Apache-inkubatoren, og spesifikasjonen er et utkast.
Regner Ossie ut nøkkeltallene? Nei. Ossie beskriver hvor et nøkkeltall er definert og hvilket språk uttrykket er skrevet i. Verktøyet som bruker modellen, gjør utregningen, og koblinger og gruppering overlates i stor grad til verktøyet. Derfor kan to verktøy gi ulike tall for samme definisjon.
Støtter Power BI og Fabric Apache Ossie? Ja, i en tidlig form. Microsoft stilte seg bak standarden i september 2026, og det finnes en konverter som gjør en Ossie-fil om til en semantisk modell for Power BI og Fabric, og tilbake, uten kobling til tjenestene. Mål fra Power BI beholdes i DAX, og bare et smalt utvalg SQL-uttrykk oversettes til DAX. Chris Webb hos Microsoft har skrevet at Power BI ikke vil fungere fullt ut med semantiske modeller fra andre leverandører.
Erstatter Ossie datakatalogen? Nei. Ossie har ingen felt for eier, forvalter, klassifisering, lineage eller kvalitetsregler. Datakatalogen og forretningsordlista eier begrepet og ansvaret, mens Ossie eier utregningen. Integrasjon med katalogen står på veikartet til prosjektet og er ikke levert.
Kan vi bruke Ossie i produksjon i dag? Spesifikasjonen sier selv at den ikke skal brukes i produksjon, og formatet endrer seg mellom versjonene. Den passer i dag til kartlegging, opprydding og migrering. Lås versjonen av spesifikasjonen og konverterne, og sammenlign tallene i to verktøy før dere stoler på dem.
Kilder
- Apache Ossie: repoet på GitHub, med spesifikasjonen, flyeksemplet i mappen examples og konverterne i mappen converters, lest 7., 8. og 15. oktober 2026.
- Apache Incubator: OssieProposal, søknaden om inkubasjon, juni 2026, og statussiden for Polaris.
- Alex Merced: Meet Apache Ossie (incubating): The Open Semantic Interchange Finds Its Home at the ASF, LinkedIn, 2026.
- Snowflake på prosjektets nettsted: Apache Ossie (Incubating): The New Name for Open Semantic Interchange.
- Snowflake: Snowflake, Salesforce, dbt Labs, and More, Revolutionize Data Readiness for AI with Open Semantic Interchange Initiative, 23. september 2025.
- Snowflake-dokumentasjonen: SYSTEM$READ_OSSIE_YAML_FROM_SEMANTIC_VIEW.
- dbt Labs: dbt Labs Affirms Commitment to Open Semantic Interchange by Open Sourcing MetricFlow, 14. oktober 2025.
- Microsoft: Microsoft & Snowflake’s Commitment to Apache Ossie, Power BI Updates Blog, september 2026.
- Snowflake: Breaking Down Semantic Silos: Microsoft Ecosystem Support Comes to Apache Ossie (Incubating), 30. september 2026.
- Chris Webb: innlegget om Power BI og semantiske modeller fra andre leverandører, 12. april 2026.
- Simon Späti: Business Intelligence, Semantic Layer, Modern OLAP, Data Virtualization, kapittel i Patterns of Data Engineering, oppdatert januar 2026.
- Simon Späti: Context, Semantics, and Ontology: A Primer for the Agentic Era, MotherDuck, 2. september 2026.
- Jochen Christ: What is Apache Ossie?, Entropy Data, 22. august 2026. Figur 3 er hentet herfra.
- Hao Wu: What Is Apache Ossie? How Does It Works?, PuppyGraph, 24. september 2026.
- Juan Sequeda: innlegg om hvordan et kontekstlag bør bygges, LinkedIn, 2026.
- Ella Pham: #30 - The why, how and what of semantic layer, Data & Beyond, 9. juni 2024.
- Silja Märdla: innlegg om semantiske lag og nøkkeltall, LinkedIn, 2026.