
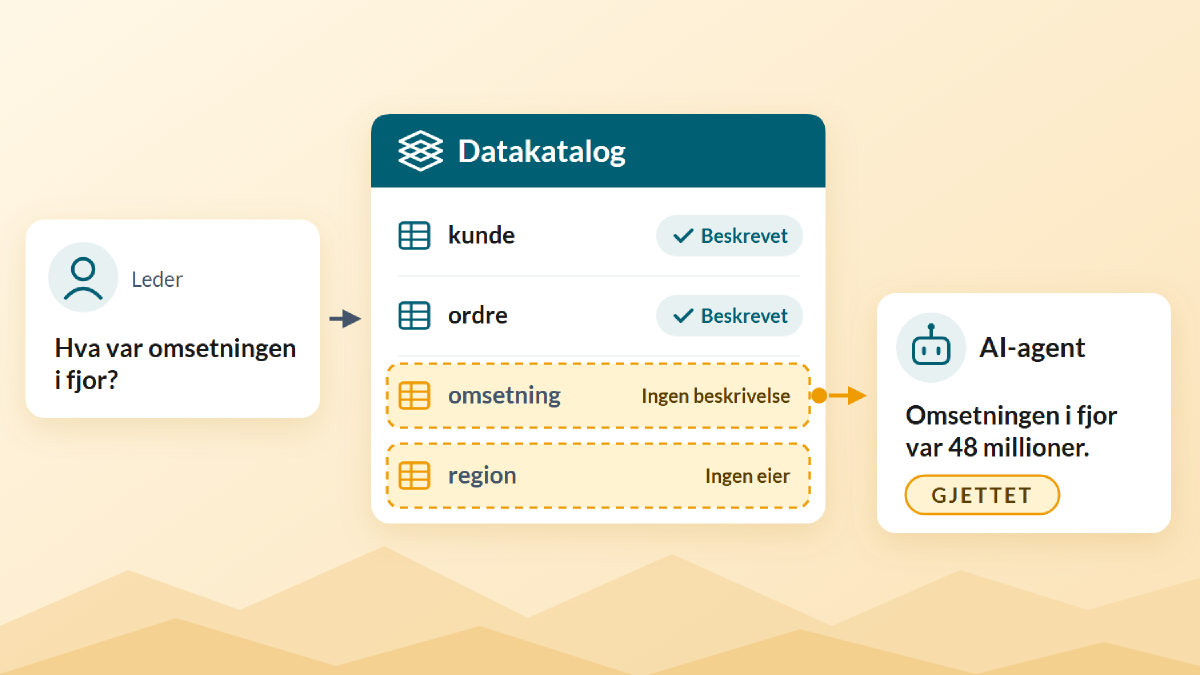
Kort fortalt: AI-agentene gjør datakatalogen obligatorisk. De slår opp i den hver gang de svarer, og der katalogen er tom, gjetter de. Derfor bør dere slutte å måle katalogen på hvor mye som er fylt ut, og begynne å måle den på om svarene blir riktige. Den halvfulle katalogen dere har, er ikke et mislykket prosjekt. Den er arbeidslista. Og en tabell uten eier skal ikke gi svar til verken mennesker eller agenter.
Vi i Glitni jobbet med en stor norsk infrastrukturvirksomhet som flyttet analyseplattformen sin til skyen. Virksomheten hadde en datakatalog, og den var halvfull. Det er ikke uvanlig.
Så lenge leserne var mennesker, gjorde det lite. Den som lurte på hva et felt betydde, spurte en kollega. Kobler dere en AI-agent til den samme katalogen i dag, skjer noe annet. Agenten spør ikke en kollega. Den leser det som står der, og der katalogen er tom, gjetter den.
En halvfull katalog var en irritasjon. Med agenter blir den en kilde til feil svar.
Katalogen ventet to ganger
Prukalpa Sankar er medgründer av katalogleverandøren Atlan. I et innlegg i september skriver hun at katalogen ventet to ganger: først på at noen skulle skrive innholdet, så på at noen skulle komme og lete. Dataene endret seg raskere enn folk rakk å dokumentere dem, og de som trengte svar, måtte gå ut av arbeidet sitt for å slå opp. Katalogen lærte heller aldri. Den ble målt på hvor mye som var fylt ut, og det tallet sier ikke om en beskrivelse hjalp noen.
Ole Olesen-Bagneux skrev boka The Enterprise Data Catalog og arbeider med andre utgave. Etter konferansen Big Data LDN oppsummerte han i oktober på LinkedIn det han mente var viktigst derfra, og tråden under innlegget sammenligner katalogen med CMDB-en, registeret IT-drift fører over systemene og hvordan de henger sammen. En av de som kommenterte, stilte spørsmålet denne artikkelen handler om. CMDB-en virket fordi ingen fikk gå utenom den, mens katalogen fortsatt er frivillig. Hva skal tvinge den fram denne gangen?
Katalogen har sjelden manglet funksjoner. Den har manglet en grunn til at noen må bruke den.
Agenten går ikke utenom
Sankar mener katalogen ikke dør, men at leseren skifter. Ifølge henne vokser en ny gruppe lesere raskest: ikke analytikeren som åpner en side i katalogen, men agenten som skal svare på et spørsmål, undersøke et avvik eller utføre en handling. En agent i Claude eller Cursor har ingen søkeboks å skrive i, så den kaller katalogen som et verktøy. Den jobben gjør MCP, protokollen som lar en AI-klient kalle tjenester direkte, med de samme tilgangene som styrer katalogen fra før.
Olesen-Bagneux beskriver samme skifte i en artikkelserie i tre deler. Den første delen, fra 21. oktober, har tittelen «Phonebook for data - Spine for AI»: katalogen går fra å være en telefonbok over dataene til å bli ryggraden AI står på. I den andre, fra 3. november, skriver han at katalogene nå brukes som en kilde i seg selv for AI, og ikke bare som en vei til andre kilder.
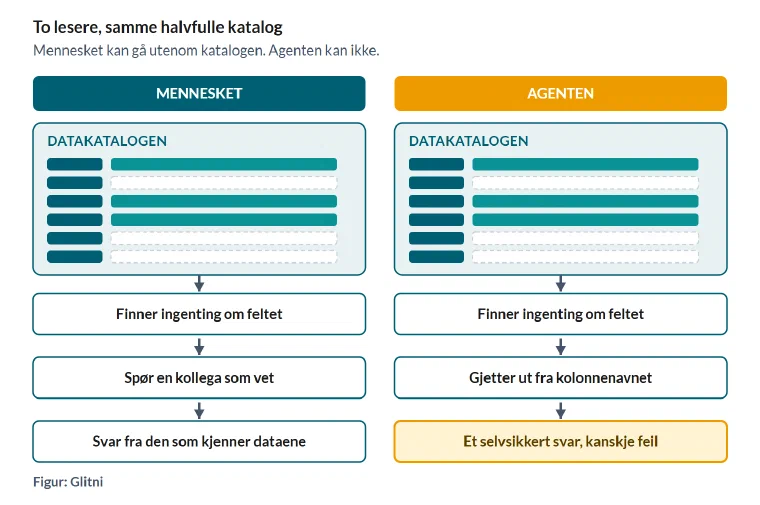
Her ligger svaret på spørsmålet om hva som skal tvinge katalogen fram. I Metadata og ontologi har blitt fundamentet AI leser fra viste vi hvor mye gjetningen koster. I forsøket til Data Culture svarte en agent med tilgang til bare tabellene riktig på null av 13 spørsmål. Med kolonnebeskrivelser ble 15 prosent av svarene riktige. Først da forretningsreglene kom inn, steg andelen til 77 prosent, med samme modell hele veien. Med definerte nøkkeltall, eksempelspørringer og en fast evaluering endte agenten på 92 prosent. En katalog hjelper altså lite hvis den bare beskriver kolonnene. Den må også fortelle agenten hvilke regler som gjelder.
Når agenten først er koblet til, trenger ingen å vedta at katalogen er obligatorisk. Agenten leser den uansett.
Mål riktige svar, ikke dekningsgrad
Katalogen har i mange år blitt målt på dekningsgrad: hvor stor andel av tabellene som har beskrivelse og eier. Sankar skriver at en katalog for agenter må måles på resultatet i stedet, altså på om agenten svarer riktig på et ekte spørsmål og kan forklare hvorfor. Vi er enige. Selv om katalogen dekker nesten alt, kan agenten svare feil på det ledelsen spør oftest om. En liten katalog kan gi riktige svar, så lenge den dekker tabellene de spørsmålene trenger.
Så lenge katalogen var frivillig, kostet en mangelfull oppføring lite. Med agenter viser kostnaden seg med en gang: agenten svarer feil, bruker feil definisjon eller kan ikke forklare hvordan den kom fram til svaret. Sankar skiller tre feil som ser like ut utenfra. Noen ganger manglet beskrivelsen. Noen ganger fantes den, men ingen hadde sjekket nøkkeltallet under. Og noen ganger var alt på plass, men agenten valgte feil. Uten et spor av hva agenten slo opp, gir teamet modellen skylden og fortsetter å justere instruksen.
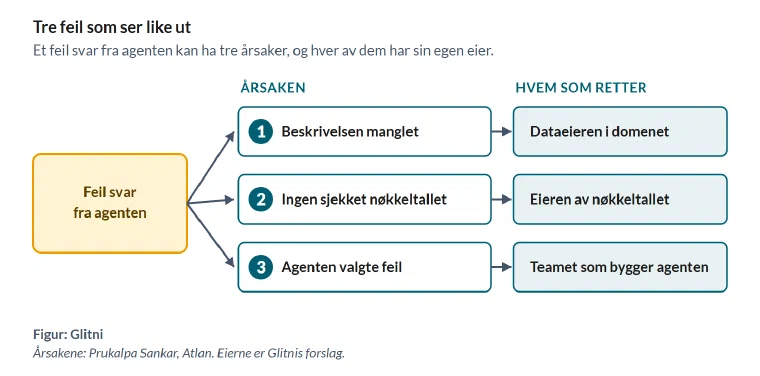
Sankar skriver at hver av de tre feilene har sin egen eier, men ikke hvem. Der går vi lenger enn kilden. Mangler beskrivelsen, er det dataeieren i domenet som skal skrive den. Er nøkkeltallet feil, er det eieren av nøkkeltallet som retter. Velger agenten feil, ligger rettingen hos teamet som bygger agenten. Uten den fordelingen havner alle feil hos datateamet.
Malcolm Hawker er Chief Data Officer i masterdataleverandøren Profisee. I et innlegg på LinkedIn i november skiller han mellom mening og sannhet. Et semantisk lag, en ontologi eller en kunnskapsgraf forteller agenten hva en aktiv kunde er, men agenten kan likevel spørre mot data der samme selskap står fem ganger. Katalogen står på samme side av skillet. Den riktige referansen kommer fra masterdatastyring, altså grunndataene vi skrev om i Domener og eiere først.
Når agenten er leseren, er en tom oppføring ikke lenger uskyldig. Den er et feil svar som venter på et spørsmål.
Den halvfulle katalogen er arbeidslista
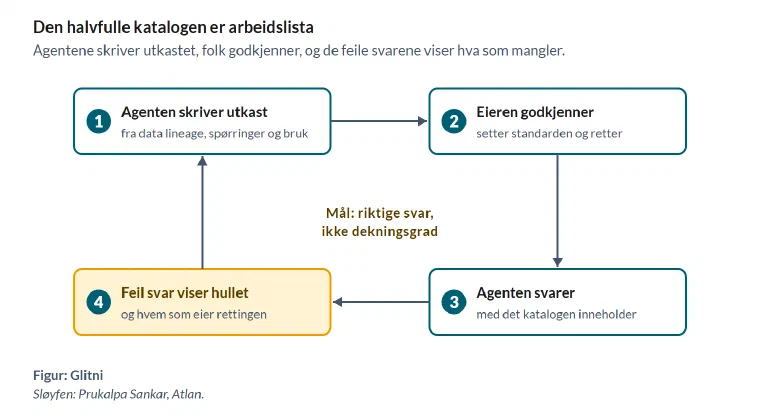
Mange vil møte en halvfull katalog med et nytt katalogprosjekt. Vi mener det er feil rekkefølge. Den halvfulle katalogen er ikke et mislykket prosjekt. Den er arbeidslista, og agentenes feile svar forteller hvilke oppføringer som skal fylles først.
Sankar svarer at agentene skal skrive førsteutkastet. De går gjennom det som alt finnes, som data lineage, spørrehistorikken og bruksmønstrene, og skriver en begrunnet beskrivelse. Folk setter standarden, avgjør det som er uklart og godkjenner det som kan stoles på. Atlan oppgir i samme innlegg at agentene skrev 1,03 millioner beskrivelser hos 50 virksomheter på tre uker, og at kvaliteten på selskapets første AI-funksjoner flatet ut rundt 70 prosent. Det er leverandørens egne tall, og hun ber selv leseren lese dem slik. Det viktigste i innlegget er sløyfen: agentene skriver, agentene leser, de feile svarene viser hullene, og folk retter det riktige laget.
Før dere kjøper en ny katalog for AI, se hva dere alt har. Noen av oss i Glitni hørte Olesen-Bagneux holde foredraget «The Meta Grid, Revisited» på Helsinki Data Week 27. oktober. I en virksomhet med mer enn tusen ansatte finnes metadataene alt i mange kopier, sa han. Informasjonssikkerhet har risikoene, personvernombudet har registeret over personopplysninger, arkitektene har arkitekturverktøyet og datateamet har katalogen. Det vanskelige er å få disse miljøene til å snakke sammen, og det løser verken et API eller en agent. Han kalte problemet sosioteknisk.
Agentene kan skrive utkastet, men de kan ikke ta over eierskapet.
Ingen eier, ingen agent
Vi har en enkel regel: en tabell uten eier skal ikke gi svar til verken mennesker eller agenter. I Domener og eiere først skrev vi at en datakatalog ikke løser noe hvis ingen eier dataene som skal stå i den. Agentene skjerper det kravet. Så lenge katalogen var frivillig, kunne en oppføring uten eier stå i årevis uten at noen merket det. Når agenten leser den, havner oppføringen i et svar til noen som skal ta en beslutning.
I Datateamets harness og kontekst avgjør mer enn modellen skilte vi kunnskapen om hvordan arbeidet gjøres, fra kunnskapen om dataene. Katalogen hører til den andre, og den kunnskapen hører til de som eier dataene.
Start smalt. Velg spørsmålene agenten skal svare på, og gjør katalogen god for tabellene de spørsmålene trenger: eier, beskrivelse og forretningsregler. Resten av katalogen kan vente til agenten trenger den.
En test
Velg ti spørsmål ledelsen ofte stiller om tallene, og la en agent svare med bare det katalogen inneholder. Gå gjennom hvert feil svar og finn ut om beskrivelsen manglet, om ingen hadde sjekket nøkkeltallet, eller om agenten valgte feil. Skriv så ned hvem i virksomheten som eier rettingen.
Klarer dere ikke å svare på det siste, vet dere hva som må på plass før agenten slipper til.
Kommentatoren i tråden spurte hva som skal tvinge katalogen fram denne gangen. Svaret er agentene.
Ofte stilte spørsmål
Hva er en datakatalog? En datakatalog er oversikten over dataene i en virksomhet: hvilke tabeller og datasett som finnes, hva de betyr, hvor de kommer fra og hvem som eier dem. Kjente verktøy er Collibra, Atlan, DataHub og OpenMetadata, og katalogene til plattformleverandørene: Unity Catalog i Databricks, Horizon i Snowflake og Purview fra Microsoft.
Hvorfor blir datakataloger stående halvfylte? Fordi ingen har måttet bruke dem. Noen må skrive beskrivelsene, dataene endrer seg raskere enn folk rekker å dokumentere, og folk kan spørre en kollega når de lurer på hva et felt betyr. Katalogen måles dessuten på hvor mye som er fylt ut, og det tallet sier ikke om beskrivelsene hjalp noen.
Hvordan bruker en AI-agent datakatalogen? Agenten slår opp i katalogen for å finne ut hvor dataene ligger, hva de betyr og hvem som eier dem, før den skriver en spørring eller et svar. Den bruker ikke katalogens søkeside, men kaller katalogen som et verktøy, ofte gjennom MCP, med de samme tilgangene som gjelder for katalogen fra før.
Hvordan måler vi om datakatalogen er god nok for AI? På andelen riktige svar agenten gir på spørsmål virksomheten stiller, ikke på hvor stor del av katalogen som er fylt ut. Gå gjennom hvert feil svar og finn ut om beskrivelsen manglet, om ingen hadde sjekket nøkkeltallet, eller om agenten valgte feil. Hver av de tre årsakene har sin egen eier.
Bør vi kjøpe en ny datakatalog for AI? Sjelden som første steg. Metadataene finnes som regel alt i flere verktøy, hos informasjonssikkerhet, personvernombudet, arkitektene og datateamet. Start med spørsmålene agenten skal svare på, og gjør katalogen dere har, god for tabellene de spørsmålene trenger.
Er en god datakatalog nok til at agenten svarer riktig? Nei. Katalogen forteller agenten hva dataene betyr, men ikke om de er riktige. Står samme kunde fem ganger i dataene, hjelper ikke en god definisjon av kunde. Den riktige referansen kommer fra masterdata og datakvalitet.
Lær mer
Relatert lesning på glitni.no:
- Metadata og ontologi har blitt fundamentet AI leser fra
- Datateamets harness og kontekst avgjør mer enn modellen
- Domener og eiere først
Kilder og videre lesning:
- Prukalpa Sankar, Is the data catalog finally dead?, Context & Chaos, 8. september 2026. Figur 2 og 3 bygger på innlegget.
- Ole Olesen-Bagneux, innlegget etter Big Data LDN med kommentarene under, LinkedIn, 3. oktober 2026
- Ole Olesen-Bagneux, Data Catalog I/III: Phonebook for data - Spine for AI, Books by Ole Olesen-Bagneux, 21. oktober 2026
- Ole Olesen-Bagneux, foredraget «The Meta Grid, Revisited», Helsinki Data Week, 27. oktober 2026
- Ole Olesen-Bagneux, Data Catalog II/III: Memory for Enterprise, Books by Ole Olesen-Bagneux, 3. november 2026
- Malcolm Hawker, innlegget om CDO Matters, episode 109, LinkedIn, 4. november 2026
- Opeyemi Fabiyi, The Boring Work That Makes AI Analytics Actually Work, Data Culture, 28. april 2026
Magne Bakkeli er medgründer og seniorrådgiver i Glitni. Han har over 25 års erfaring med dataplattformer, data governance og dataarkitektur, og ledet Data & Analytics-teamet i PwC Consulting i 12 år. Han har bygget og modernisert dataplattformer i kraft, FMCG, finans og media.