
Innhold
Datakvalitet: hvor gode må dataene være, og hvem bestemmer det?

Kategori: Data Governance | Emneknagger: #Podcast, #Datakvalitet, #Data Governance
AI-agenter stoler på dataene de får, og det gjør datakvalitet til en forutsetning for alt annet vi gjør med data. Bjarte Tolleshaug og Magne Bakkeli forklarer hvorfor kvalitet måles mot formålet, hvor du bør begynne, og hvorfor det meste av jobben handler om folk.
Sist oppdatert: oktober 2026. Artikkelen bygger på samtalen med Bjarte Tolleshaug i episode 19 av podkasten Datautforskerne.
Kort fortalt: Hvor gode dataene må være, avhenger av hva de skal brukes til. Velg de få dimensjonene som betyr noe for formålet, prioriter etter hva feilene koster, begynn med master- og referansedata, og gjør kostnaden ved dårlig datakvalitet synlig. Det meste av jobben handler om folk og eierskap, ikke om verktøy.
I episode 19 av Datautforskerne snakket jeg med Bjarte Tolleshaug, sjefskonsulent og fagleder for skyteknologi og data i Experis Bergen, om hvorfor datakvalitet har blitt forutsetningen for AI, og hvordan du kommer i gang uten å prøve å sjekke alt.
Du gir en AI-agent en oppgave og et datagrunnlag, og den løser den. Raskt, selvsikkert, og med et språk som får det til å høres riktig ut. Problemet er det Bjarte beskriver slik: “Setter du opp agenter til å jobbe på et datagrunnlag, tar de for god fisk at det som ligger der er riktig, og stiller ikke så mye spørsmål ved det de finner.” En medarbeider ville gjort det samme hvis du forklarte oppgaven dårlig og ga feil tall. Forskjellen er at mennesket ofte nøler, mens agenten svarer selvsikkert uansett om grunnlaget er godt eller dårlig.
Det er her datakvalitet har gått fra å være et litt kjedelig fag i bakgrunnen til å bli forutsetningen for alt vi prøver å få til med data. Rotårsaken til at AI-løsninger bommer, er som regel ikke modellen, men at dataene og konteksten under den ikke er gode nok. Tallene peker samme vei: McKinsey fant i juni 2026 at bare 7 prosent av selskapene har skalert AI i hele virksomheten, og at over to tredjedeler av de som lykkes best, peker på data som det viktigste hinderet (McKinsey). AI har gitt datakvalitet den oppmerksomheten den alltid burde hatt.
Dataene må være gode nok til et bestemt formål
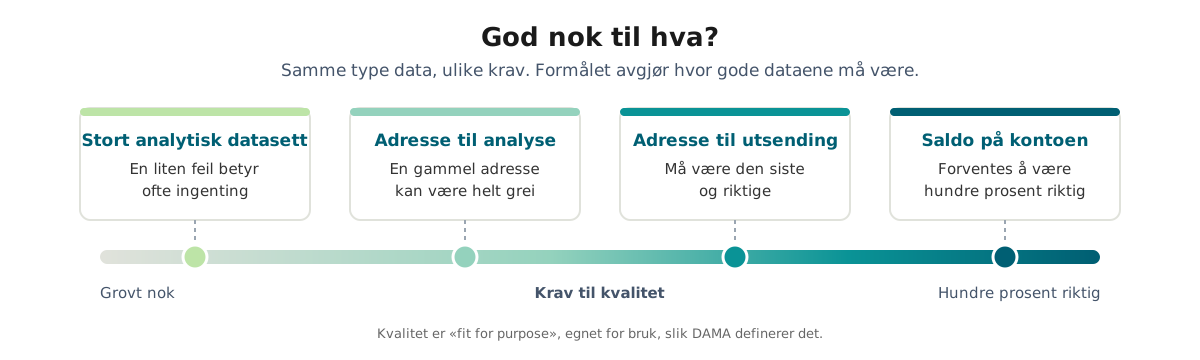
Den mest nyttige definisjonen av datakvalitet er også den enkleste. DAMA, den internasjonale foreningen som fremmer god dataforvaltning, kaller det «fit for purpose»: egnet for bruk. Kvalitet måles ikke i et vakuum, men mot formålet dataene skal brukes til. Som Bjarte sier: “Kvaliteten på data kan være bra til noe, men ikke til noe annet.”
Ta en postadresse i kunderegisteret. Skal du gjøre historisk analyse, kan en gammel adresse være helt grei. Skal du sende en vare, må den være den siste og riktige, og da vil du kanskje bekrefte med kunden før du sender. Samme datafelt, to helt ulike krav. Skal du sjekke saldoen på kontoen din, forventer du at tallet er hundre prosent riktig. Kommer det en liten feil i et stort analytisk datasett, betyr det ofte ingenting. Kvalitet er kontekstdrevet, og konteksten avgjør hvor gode dataene må være.
Denne enkle innsikten er lett å glemme når du setter i gang et «datakvalitetsprosjekt». Uten et formål å måle mot ender du opp med å jakte på perfeksjon overalt, og perfeksjon overalt er dyrt. Veldig dyrt.
Kvalitet er mer enn om tallet er riktig
Vi tenker gjerne på datakvalitet som spørsmålet om et tall stemmer. Det er bare en del av svaret. Like ofte handler det om begrepene og definisjonene, altså semantikken: mener vi det samme med «aktiv kunde» på tvers av systemene? Datakvalitet handler om metadata, om ferskhet, og om at dataene er modellert på riktig nivå. Aggregerer du for hardt allerede ved innsamling, mister du informasjonen du senere trengte.
Bjarte bruker et klassisk romfartseksempel for å vise hvor galt det kan gå når begrepene glipper: NASAs romsonde Mars Climate Orbiter gikk tapt i 1999 fordi bakkeprogramvaren regnet i amerikanske måleenheter, mens programvaren om bord regnet metrisk (NASA). Tallene var i og for seg riktige. Det var betydningen av dem som var feil.
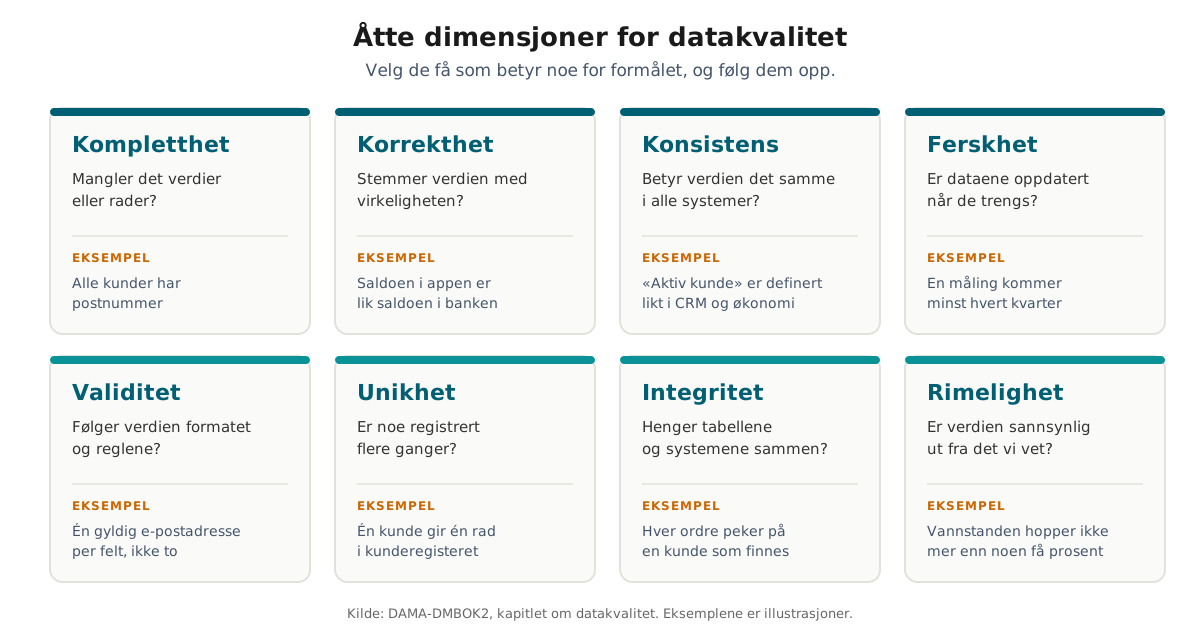
For å gjøre kvalitet målbar trekker Bjarte frem åtte dimensjoner fra DMBOK, DAMAs kunnskapsverk: kompletthet, korrekthet, konsistens, ferskhet, validitet, unikhet, integritet og rimelighet. Du trenger sjelden alle åtte. Poenget er å velge de få som betyr noe for formålet, og følge dem opp.
Du kan ikke sjekke alt
Med moderne verktøy kan du sette opp kvalitetssjekker på nesten hva som helst. Nettopp derfor er den viktigste beslutningen hva du ikke skal sjekke. Bjarte har sett hva som skjer ellers: “Vil du virkelig sjekke alt, tester du det i hjel. Da bruker du mer tid på å holde kontroll på testene dine enn på å få ut verdien.”
Prioriteringen bør styres av konsekvens. Et feil tall i en analyse er kjedelig, men det lever du med. En feil som får et styringssystem til å åpne en sluse den ikke skulle, eller som mater en selvkjørende bil med gale data, er en helt annen sak. For en av Glitnis kunder i kraftbransjen er en enkel vannstandssensor utgangspunktet for god eller dårlig datakvalitet. Sensoren er «dum», og hvis den flater ut, kan det bety at noe er feil. Oppdages det ikke, forplanter feilen seg oppover til produksjonsprognoser og innmelding til nettet, der det står store verdier på spill. Selve mottiltaket er billig: enkle rutiner, folk som kjenner anlegget, kanskje et kamera. Det dyre er å ikke vite.
Det naturlige startpunktet er master- og referansedata: kunde, produkt, leverandør, organisasjon, oppslagslister og hierarkier. Det er de sentrale kildene mange systemer er avhengige av, og de gir mest igjen for innsatsen. Er du i en regulert bransje som bank, energi eller helse, er kravene til rapportering et opplagt sted å begynne. Én god test på hva som er verdt å sikre: hva skjer om du mister disse dataene, og klarer du å gjenskape dem? Begynn smått og utvid litt etter litt. Sjekker for kompletthet, ferskhet, unikhet og validitet koster lite å sette opp, og er et godt sted å starte.
Regn på hva dårlig datakvalitet koster
Den raskeste veien til å få gehør for datakvalitet er å gjøre kostnaden konkret. Bjarte bruker et regneeksempel fra markedsføring: en virksomhet sender ut 16 000 henvendelser, men mister 3 000 av dem hver gang på grunn av feil i dataene. Vet du at hver nye kunde er verdt 1 800 kroner, blir tapet plutselig lett å sette tall på.
Et annet eksempel er fakturering. Sender du fakturaer med feil, blir de bestridt, og betaling som skulle kommet på 30 dager glir ut til 90. På toppen kommer den manuelle oppfølgingen, som er en skjult lønnskostnad. Når du kan feste et kronebeløp på dårlig datakvalitet, får arbeidet med datakvalitet den oppmerksomheten det trenger. Uten et tall forblir det en teknisk detalj ingen prioriterer.
Kostnaden er bare den ene siden av regnestykket. Sebastian Wernicke peker i Modern Data 101 på den andre: alle de vanlige dimensjonene måles i det øyeblikket dataene produseres, og ingen av dem sier om dataene endret en beslutning. Hans første, grove mål er ett spørsmål: hvor ofte ser noen på dataene før en beslutning, og ombestemmer seg? I mange virksomheter er det ærlige svaret «sjelden», og det alene bør endre hva dere prioriterer.
Det handler om folk, ikke teknologi
Teknologien for å måle og forbedre datakvalitet finnes for lengst. Flaskehalsen er nesten alltid en annen: at de som skaper og bruker dataene ikke er bevisste på at dataene skal skapes og brukes et annet sted. Mitt anslag i samtalen var at sytti til åtti prosent av problemet ligger der, og Bjarte var enig. Jobben er å få de rette menneskene i samme rom og skape eierskap og ansvar. Bjarte har plukket opp et uttrykk han liker godt: “Det handler om å hjelpe noen å gjøre det riktig første gangen.”
Her kommer rollene inn. I DAMAs språk er en dataeier den som tar beslutningene om et sett med data, typisk en leder i forretningen som har mest å tape på at dataene er feil. En dataforvalter er den som gjør det operative, og kan være både teknisk og fagekspert. I praksis er dette ofte femprosents-roller, ikke egne stillinger, og da blir det ekstra viktig at ansvaret er tydelig plassert. Eskalerer du beslutningene for høyt opp i ledelsen for å få gjennomslagskraft, mister du samtidig kjernekunnskapen hos de som forstår hva dataene betyr.
Skal dette skaleres i en større organisasjon, ender de fleste på en føderert modell: felles standarder sentralt, lokalt eierskap i domenene. Det er den samme innsikten vi i Glitni ser igjen og igjen i norske virksomheter. Sentral styring på prinsippene, lokal ansvarliggjøring på dataene. Et godt første grep, uansett størrelse, er å dele datalandskapet inn i domener med felles vokabular og tegne et kart over dem. Da har dere noe å plassere eierskapet på, og noe å peke på når dere diskuterer.
Når folk og formål er på plass, kommer verktøyene
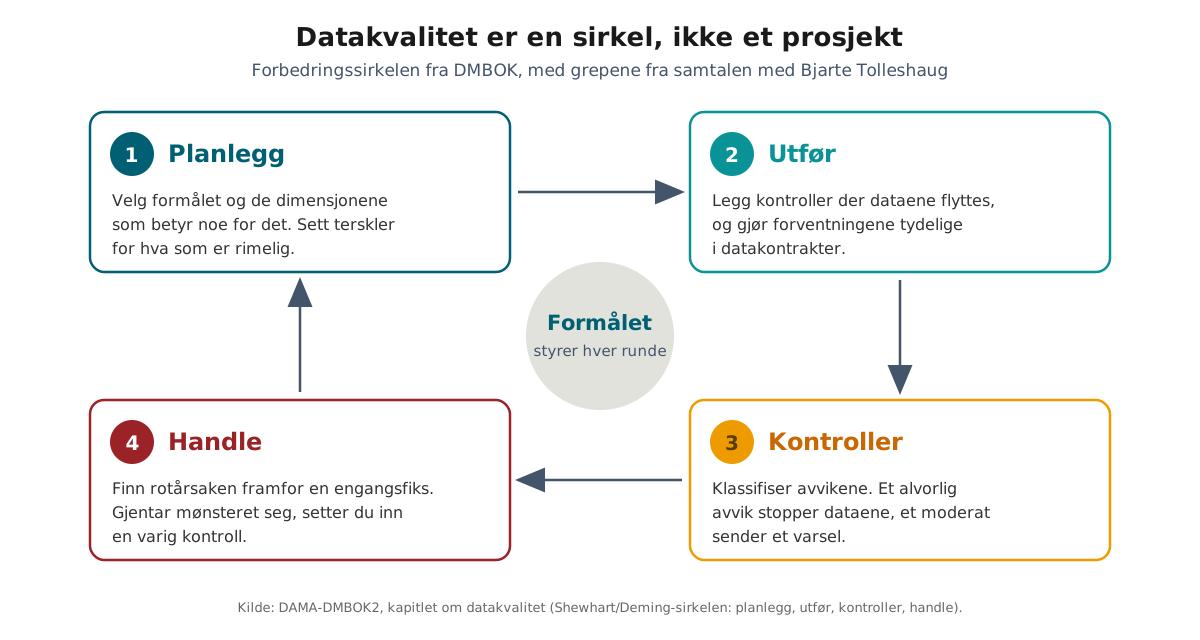
Her er det rikelig å ta av. Datakontrakter gjør forventningene mellom produsent og konsument tydelige, slik at en endring i et kildefelt ikke bare får rapporten lenger nede til å feile stille. I pipelinen kan du legge på kontroller for hver gang data flyttes, med referanseintervaller for hva som er rimelig. For vannstandssensoren kan det være et krav om at en måling kommer minst hvert kvarter, og at verdien ikke hopper mer enn noen få prosent.
Avvik bør klassifiseres, ikke behandles likt. Et alvorlig avvik kan stoppe dataene fra å forplante seg videre, mens et moderat avvik heller sender et varsel. Og når noe først har gått galt, er poenget å finne rotårsaken og hindre gjentakelse, ikke å gjøre en engangsfiks. Rettingen hører hjemme der dataene skapes. “Det er alltid anbefalt å rette det ved kilden, selv om verden ikke alltid er like enkel,” sier Bjarte. Ser du det samme mønsteret flere ganger, er det der du setter inn en varig kontroll. Alt dette henger sammen med lineage, altså sporbarhet, som lar deg se hvor i kjeden det brakk.
DMBOK beskriver dette forbedringsarbeidet som en sirkel i fire steg: planlegg, utfør, kontroller og handle, kjent som PDCA-sirkelen (Plan-Do-Check-Act). Arbeidet blir aldri ferdig, fordi god kvalitet i dag forvitrer når systemer endres og nye data kommer inn. Hver runde starter med formålet, og hver varig kontroll gjør neste runde billigere.
Til slutt kommer tilliten. En lydbok Bjarte trekker frem, «The Speed of Trust» av Stephen M.R. Covey, har et enkelt poeng som passer godt på data: jo mer tillit, desto høyere fart. Deler du et dataprodukt av høy kvalitet, med en kvalitetsindikator konsumenten kan se, slipper mottakeren å kontrollere alt på nytt. “Når du deler noe med noen og de hele tiden sjekker det, tar det kjempelang tid. Og tid er penger,” sier Bjarte. God datakvalitet er derfor ikke bare risikoreduksjon, det er hastighet.
Når det er en AI-agent som bruker dataene
Et menneske som ser et rart tall, stopper opp og spør. En AI-agent gjør det sjelden, og derfor må kvalitetssignalet være noe maskinen kan lese, ikke bare noe folk vet. Robert Sahlin beskriver hvordan dataplattformteamet i Nordnet har gjort det: hvert dashbord viser et helsemerke i grønt, gult eller rødt, regnet ut fra testene og avvikene i alle tabellene oppstrøms. Den samme statusen er laget for å leses av maskiner. En agent som skal skrive en SQL-spørring, kan først sjekke om tabellene har aktive avvik og advare brukeren, og en modell som trenes på nytt hver natt, kan avbryte og beholde forrige versjon når treningsdataene står på rødt.
Testene får også en ny rolle. Ido Bronstein, som leder Upriver, et selskap som selger automatisering av data engineering, lot en språkmodell jobbe uten tilsyn med ekte data engineering-oppgaver i to uker. Konklusjonen hans er at en agent bare trygt kan få jobben der det finnes en kjørbar definisjon av hva som er riktig, og at datakvalitetstestene derfor har blitt det hele systemet hviler på (Upriver). Det er det samme spørsmålet som før: den som har skrevet ned hva som er godt nok, kan også la en maskin gjøre mer av jobben. Vi har skrevet mer om hva som skiller analyseklare og AI-klare dataprodukter, og om tre måter AI lyver for deg i data engineering.
Hvor du begynner
Er du data engineer og ser et kvalitetsproblem, er det fristende å sette opp en teknisk sjekk med en gang. Det bedre første steget er å snakke med den som eier forventningen til brukstilfellet: hva betyr disse dataene, og hva er godt nok? Bjarte åpner gjerne slike samtaler med fageksperter slik: “Jeg kan ekstremt lite om det du kan veldig mye om, men jeg ser den røde tråden i hva utfordringene er.” Definer problemet sammen med de som forstår rotårsaken, og design løsningen etterpå. Noen ganger er svaret enkelt, som å bytte fra e-post til mobilnummer som identifikator for å få mer unike nøkler på kundesiden.
Den røde tråden gjennom hele samtalen er at datakvalitet ikke er en teknologioppgave du kan kjøpe deg ut av. Det er en prioriteringsøvelse forankret i formål, og en kulturendring forankret i folk. Start med det som betyr mest, gjør kostnaden ved dårlig datakvalitet synlig, og få de rette menneskene til å snakke sammen. Resten er mekanikk.
Tre spørsmål før du setter opp neste kvalitetssjekk
- Hvilket formål skal dataene være gode nok til? Kan du ikke svare, vet du heller ikke hva du skal måle.
- Hva koster det hvis dataene er feil? Er svaret lite, holder en enkel sjekk, eller ingen.
- Hvem eier forventningen? Har ingen i forretningen sagt hva som er godt nok, er det dem du skal snakke med først.
Vanlige spørsmål om datakvalitet
Hva er datakvalitet? Datakvalitet betyr at dataene er egnet for formålet de skal brukes til, det DAMA kaller «fit for purpose». Den samme postadressen kan være god nok til historisk analyse og for dårlig til å sende en vare. Kvaliteten måles derfor alltid mot bruken, ikke som ett tall for hele virksomheten.
Hvilke dimensjoner måler datakvalitet? DAMAs kunnskapsverk DMBOK beskriver åtte vanlige dimensjoner: kompletthet, korrekthet, konsistens, ferskhet, validitet, unikhet, integritet og rimelighet. Få virksomheter trenger alle åtte. Velg de dimensjonene som betyr noe for formålet, sett referanseverdier for hva som er rimelig, og følg dem opp der dataene flyttes.
Hvor bør vi begynne med datakvalitet? Begynn med master- og referansedata som kunde, produkt og leverandør, fordi mange systemer er avhengige av dem. I regulerte bransjer som bank, energi og helse er rapporteringskravene et opplagt startpunkt. Prioriter etter konsekvens: hva koster det om disse dataene er feil, og klarer du å gjenskape dem?
Hvordan regner vi på hva dårlig datakvalitet koster? Fest et kronebeløp på feilene. Sender du 16 000 henvendelser og mister 3 000 av dem på grunn av feil i dataene, og hver nye kunde er verdt 1 800 kroner, er tapet lett å regne ut. Feil på fakturaer gir bestridte krav, betaling som glir fra 30 til 90 dager, og manuelt etterarbeid.
Hvem har ansvaret for datakvalitet? Dataeieren tar beslutningene om et sett med data og er typisk en leder i forretningen som har mest å tape på feil. Dataforvalteren gjør det operative arbeidet. I større organisasjoner ender de fleste på en føderert modell, med felles standarder sentralt og lokalt eierskap i domenene.
Hør hele samtalen med Bjarte Tolleshaug
Hør på podcasten «Datautforskerne», episode 19, der Bjarte Tolleshaug og Magne Bakkeli snakker om datakvalitet og AI. Episoden er tilgjengelig på Spotify, Apple og Acast. I episode 16 snakket vi om hvordan virksomheter får verdi fra data.
Forsidebilde: Blåsjø mot Førrevassdammen i Ulla-Førre. Dammer som denne har vannstandssensorer, og målingene gir grunnlag for operasjonelle og kommersielle beslutninger om kraftproduksjonen. Foto: Martin NH via Wikimedia Commons, lisens CC BY-SA 3.0.
