
Kort fortalt: Datamodellering har gått inn og ut av moten i tretti år, og AI-agentene har gjort faget aktuelt igjen. AI spiller to roller: den skriver modellene, og den bruker dem til å svare på spørsmål. En språkmodell kan lage dbt-modellene når noen har sagt hvilke spørsmål de skal svare på, men den finner ikke begrepene i virksomheten selv. Agentene som bruker modellen, bommer der modellen er tvetydig. Jobben flytter seg derfor fra å skrive tabellene til å bestemme detaljnivået, begrepene og definisjonene.
Claire Gouze, medgründer og daglig leder i nao Labs, ville vite hva som gjør en AI-agent for analyse pålitelig. Hun startet uten kontekst og la på én kilde om gangen, mens hun målte hvor ofte agenten svarte riktig. Profilering av tabellene og historikk over tidligere spørringer stoppet på rundt 40 prosent. Agenten bommet fordi to kolonner kunne bety det samme, og fordi et nøkkeltall var regnet litt ulikt i to tabeller. Da hun gjorde om deler av datamodellen og skrev dokumentasjon, kom hun opp i rundt 90 prosent, forteller hun til dbt Labs. Tallene er fra hennes eget forsøk og er ikke målt av andre.
Feilene agenten gjorde, er ikke nye. En nyansatt analytiker gjør de samme feilene den første uka, før noen har forklart hvilken kolonne som gjelder. Forskjellen er at analytikeren kan spørre en kollega, mens agenten svarer med god selvtillit.
Datamodellen er der AI-en møter virksomheten. AI kan skrive modellen, og AI kan bruke den, men AI kan ikke bestemme hva den skal bety. Det er derfor datamodellering er viktig igjen.
Hvorfor går datamodellering inn og ut av moten?
På 1990- og 2000-tallet var informasjonsarkitekten en sentral figur i datavarehusets storhetstid. Jobben var å samle data fra ulike kildesystemer, harmonisere dem og gi virksomheten ett samlet bilde av dataene sine. Bøkene til Bill Inmon og Ralph Kimball ga faget teorien om normalisering, fakta og dimensjoner, og den teorien ligger fortsatt under de fleste dataplattformer.
Så kom data scientistene fra rundt 2011. Oppmerksomheten flyttet seg til ustrukturerte og semistrukturerte data, eksperimentering og fleksibilitet. Hadoop og NoSQL-databaser gjorde det enklere å lagre alt først og tenke etterpå, og data lakes skulle håndtere større datamengder med færre regler. Informasjonsarkitektene ble delvis parkert på sidelinjen.
Med lakehouse-plattformene kom de tilbake. Når rådata og modellerte data skal leve side om side, må noen holde orden på hva som er hva, og struktur ble viktig igjen. Informasjonsarkitektens comeback var temaet da denne artikkelen kom ut første gang i 2024.
AI-agentene er neste sving, og den går samme vei. En agent kan lese hundre kolonner og all dokumentasjonen på sekunder, men den kan ikke gjette hva virksomheten mener med en kunde, en ordre eller et salg.
Hva gjør AI med datamodelleringen?
AI kommer inn i datamodelleringen fra to kanter. Den ene er det AI lager. Kodeagenter som Claude Code og Codex skriver SQL, dbt-modeller, tester og dokumentasjon på sekunder, og de skriver en stadig større del av koden i datateamene. Den andre er det AI trenger. En AI-agent som skal svare på spørsmål om salg eller kunder, bruker datamodellen som kart, og den kan bare svare riktig der kartet stemmer.
Juha Korpela, grunnlegger av rådgivningsselskapet Datakor Consulting, beskriver de samme to kantene. Han skriver at modelleringen endrer seg like mye av koden AI lager som av konteksten AI trenger, og at begge deler flytter arbeidet vårt oppover. Vi går fra å tegne tekniske databaseskjemaer til å beskrive begreper og betydning, og fra å modellere én løsning om gangen til å finne sammenhengen i hele virksomheten. Metodene har vi hatt hele tiden, skriver han. AI minner oss bare på å gå tilbake til forretningsbrukerne for å forstå hvordan virksomheten fungerer, og hva de trenger svar på.
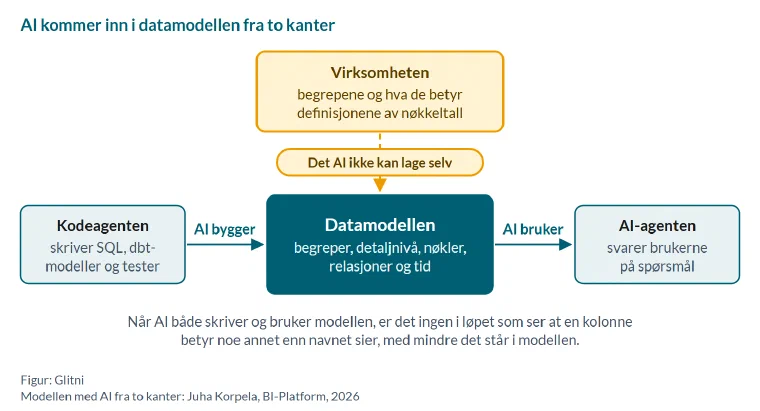
Når agentene både skriver og bruker modellen, kan ingen i løpet oppdage at en kolonne betyr noe annet enn navnet sier, med mindre noen har skrevet det inn i modellen. Derfor blir modellen viktigere, ikke mindre viktig.
Kan AI modellere selv?
Ja, når noen har bestemt hva modellen skal svare på. dbt Labs testet i april hvor godt språkmodeller svarer på elleve forretningsspørsmål mot et sterkt normalisert skjema. Med hele skjemaet som kontekst svarte Claude Sonnet 4.6 riktig i 64,5 prosent av tilfellene når den skrev SQL-en selv. Så ba teamet en språkmodell om å lage så få dbt-modeller som mulig for å kunne svare på alle elleve spørsmålene. Den lagde tre nye modeller som slo sammen noen av tabellene, uten at teamet skrev kode. Med de tre modellene steg andelen riktige svar til 90,0 prosent, og svarene gjennom det semantiske laget steg til 98,2 prosent. Vi har skrevet mer om målingen i artikkelen om metadata og ontologi for AI.
Elleve spørsmål med kjent fasit er likevel ikke et fullt ut formulert oppdrag. Fra et kravdokument går det dårligere. Arthur F. Siqueira og kollegene hans i Brasil ba to språkmodeller, GPT-5.1 og Qwen-3, om å lage datamodeller fra tre kravdokumenter om hvordan et sykehus holder oversikt over personene som kommer inn. Ingen kombinasjon av språkmodell og instruks dekket alle kravene. Best var GPT-5.1 med tankerekke og et eget kontrollsteg, og den oppfylte i snitt en tredjedel av kriteriene for fullstendighet. Noen av oppsettene scoret bedre på klarhet og enkelhet. Diagrammene så altså ryddige ut, men manglet begreper og regler som sto i kravene.
Forskjellen mellom de to forsøkene følger nivåene i en datamodell. Korpela skiller mellom tre:
- Begrepsmodellen beskriver begrepene i virksomheten og hvordan de henger sammen, uavhengig av teknologi. Den gjelder så lenge virksomheten driver på samme måte.
- Den logiske modellen gir dataene den formen et bestemt bruksområde trenger, som en dimensjonell modell, Data Vault, en normalisert modell eller én stor tabell. Én begrepsmodell kan gi flere logiske modeller.
- Den fysiske modellen er implementasjonen på plattformen, med nøkler, indekser og partisjoner.
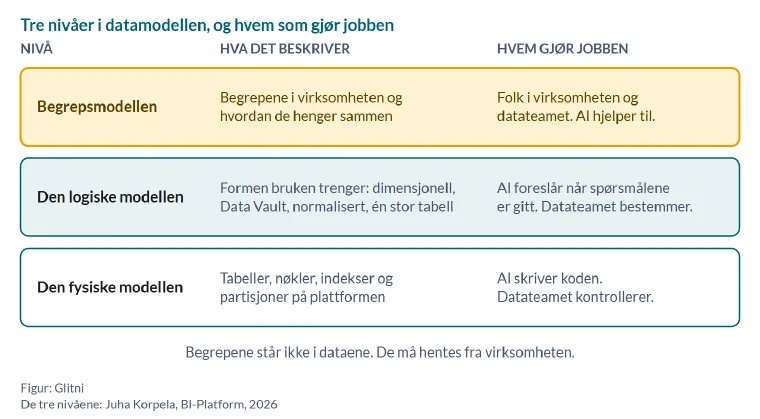
AI tar den fysiske modellen først. dbt-forsøket viser at AI også kan foreslå en logisk modell når spørsmålene er gitt. Begrepsmodellen klarer ikke AI alene, fordi begrepene ikke står i dataene. De sitter i hodene til folk i virksomheten, i avtalene og i måten selskapet tjener penger på.
Vi mener vi fortsatt er et stykke unna at AI greier å lage datamodeller som kan gjenbrukes og aksepteres bredt på tvers av en virksomhet. Men vi kan komme et stykke på vei, og AI-assistert modellering er et greit første steg.
Hva trenger en AI-agent fra datamodellen?
Joe Reis, medforfatter av boka Fundamentals of Data Engineering, publiserte i august et manifest for det han kaller Mixed Model Arts. Grunnbegrepene er de samme enten du modellerer et transaksjonssystem, et datavarehus eller en kunnskapsgraf: entiteter, relasjoner, identitet, detaljnivå, tid og semantikk. Modellene må nå fungere for både mennesker og agenter, skriver han. Vi bruker grunnbegrepene hans som sjekkliste for hva en agent trenger fra modellen:
| Grunnbegrep | Spørsmålet modellen må svare på | Hva agenten gjør når svaret mangler |
|---|---|---|
| Entiteter | Hvilke ting finnes i virksomheten, og hva heter de? | Velger tabellen med navnet som ligner mest på ordene i spørsmålet |
| Identitet | Hva er nøkkelen til en kunde eller et produkt? | Teller samme kunde to ganger fordi den finnes i to kildesystemer |
| Relasjoner | Hvordan henger tabellene sammen, og hvor mange rader møter hverandre? | Kobler tabellene feil og ganger opp radene |
| Detaljnivå | Hva er én rad? | Summerer ordrelinjer som om de var ordre |
| Tid | Gjelder verdien nå, eller da hendelsen skjedde? | Bruker dagens kundesegment på fjorårets salg |
| Semantikk | Hva betyr kolonnen, og hvor er nøkkeltallet definert? | Velger den av to like kolonner som passer best med ordlyden |
Den siste raden beskriver feilene Gouze fant. Løsningen er sjelden mer kontekst rundt en uklar modell. Den er å rydde i modellen: ett navn per begrep, én definisjon per nøkkeltall, og nøkler og relasjoner som er deklarert i stedet for underforstått. Beskrivelsene, forretningsreglene og det semantiske laget bygger på modellen. Hvordan dere bygger og vedlikeholder det laget, har vi skrevet om i artikkelen om datateamets harness og kontekst.
Stjerneskjema eller én stor tabell?
Vi får ofte spørsmålet om AI-agenter klarer seg bedre med én bred tabell enn med et stjerneskjema, fordi de slipper å koble tabeller. Vi har ikke funnet en publisert måling som beholder spørsmål, språkmodell og kontekst fast, og bare bytter type datamodell. Fivetrans sammenligning fra 2022 gjelder hvor raskt spørringene kjører, ikke om svarene blir riktige.
Vi mener formen er et valg på det logiske nivået, og at den skal følge bruken. Et stjerneskjema med felles dimensjoner for flere faktatabeller holder definisjonene på ett sted, og det er en fordel når mange skal bruke samme kunde og samme produkt. En bred tabell bygget på stjerneskjemaet kan være et godt grensesnitt for en agent som får de samme spørsmålene igjen og igjen, så lenge kolonnene arver definisjonene og ikke lager nye. Agenten blir sjelden usikker av antallet koblinger. Den blir usikker når to steder i modellen svarer forskjellig på samme spørsmål.
Hvem modellerer når agentene skriver koden?
Da artikkelen kom ut første gang, skrev vi at vi heller vil ha data engineers som kan modellere, enn rendyrkede informasjonsarkitekter som ikke koder. Med kodeagenter står det standpunktet sterkere. Når agenten skriver SQL-en på sekunder, er det ikke skrivingen som tar tid. Tiden går med til å se om modellen agenten foreslår har riktig detaljnivå, og om den bruker definisjonene virksomheten er enige om. Den vurderingen krever en som både kan modellere og kjenner koden.
I mange virksomheter er det ingen som eier modellen. Joe Reis spurte 334 fagfolk i april hvem som tar modelleringsbeslutningene hos dem. Av dem svarte 42,5 prosent den som bygger datapipelinen, og 7,8 prosent svarte at ingen gjør det og at modellene vokser fram av seg selv. Bare 19,2 prosent har en egen modellerer eller arkitekt. Når det er en kodeagent som bygger datapipelinen, blir modellen et biprodukt av det agenten skriver, med mindre noen eier den. Bare 16 av de 334 mente at bedre verktøy ville løftet modelleringen mest. Resten pekte på opplæring, krav, tid og eierskap.
Vår erfaring er at språkmodellene og brukerne deres, som ofte ikke er fagfolk på data, har en tendens til å løse sitt eget problem. Bruker vi bare språkmodeller til å modellere, kan vi ende med datamodellkaos, og vi kommer lenger unna den evige visjonen om én sannhet.
Mer av tiden går nå til begrepsmodellen. I en virksomhet med flere domener er utfordringen den samme som før: domenene må ikke lage hver sin definisjon av de samme begrepene. Er kunden den som betaler fakturaen, den som får varen levert, eller kjeden butikken hører til? Svarer to domener ulikt, får dere to tall som begge ser riktige ut, og en agent som henter data fra begge domenene, har ingen måte å vite hvilket som gjelder. Noen må eie de felles definisjonene, og den jobben blir større når agentene bruker data på tvers av domenene.
Hvordan rollene i datateamet endrer seg, har vi skrevet mer om i artikkelen om agentbasert AI og datarollene.
Hvor bør dere begynne?
AI-assistert modellering betyr at AI foreslår og dere velger. Valgene krever at dere forstår datamodellering som håndverk, slik faget har vært siden 1980-tallet. Slik kan dere begynne:
- Velg ett område. Ta et domene eller et sett nøkkeltall dere får mange spørsmål om, gjerne 10 til 20 tabeller, slik Gouze anbefaler.
- Skriv ned spørsmålene. Lag et evalueringssett med ekte forretningsspørsmål og fasit. Spørsmålene er også bestillingen til AI-en som skal bygge modellen, slik dbt-forsøket viste.
- Lag begrepsmodellen sammen med forretningsbrukerne. Bli enige om begrepene, hva de betyr og hvordan de henger sammen, før noen skriver SQL. Én side med begreper og relasjoner holder for et domene.
- Modeller med AI som assistent. La kodeagenten foreslå den logiske og den fysiske modellen, men ta valgene om detaljnivå, nøkler, delte dimensjoner og definisjoner selv. Det holder ikke å lese gjennom det agenten lager.
- Mål, og rett modellen der agenten bommer. Kjør evalueringssettet og se hvor agenten svarer feil. Rett modellen, ikke instruksen, når feilen er en tvetydig kolonne eller et nøkkeltall regnet to steder.
En test: be en AI-agent om tre tall dere rapporterer hver måned, og sammenlign svarene med rapporten. Dere vet hvor jobben begynner hvis forklaringen på et avvik er en kolonne som kan bety to ting, eller et tall som er regnet ulikt to steder.
Vanlige spørsmål om datamodellering og AI
Er datamodellering fortsatt viktig når AI kan skrive SQL? Ja, og viktigere enn før. AI skriver koden raskt, men svarene blir bare riktige der modellen er entydig. Claire Gouze i nao Labs kom fra rundt 40 til rundt 90 prosent riktige svar i sitt eget forsøk da hun ryddet i datamodellen og skrev dokumentasjon.
Kan AI lage datamodellen for oss? AI kan lage den fysiske modellen, og ofte den logiske, når noen har bestemt hvilke spørsmål den skal svare på. dbt Labs lot en språkmodell lage tre dbt-modeller som løftet andelen riktige svar fra 64,5 til 90,0 prosent. Fra et kravdokument går det dårligere. I en studie fra 2026 oppfylte den beste språkmodellen bare en tredjedel av kriteriene for fullstendighet.
Hva trenger en AI-agent fra datamodellen? Agenten trenger et tydelig detaljnivå, nøkler og relasjoner som er deklarert, et svar på hvilket tidspunkt en verdi gjelder, og ett navn og én definisjon per begrep og nøkkeltall. De vanligste feilkildene er to kolonner som kan bety det samme, og et nøkkeltall som er regnet ulikt i to tabeller.
Er stjerneskjema eller én stor tabell best for AI-agenter? Vi har ikke funnet en publisert måling som avgjør det. Formen bør følge bruken. Det viktigste er at definisjonene står ett sted, så to tabeller ikke svarer ulikt på samme spørsmål.
Kilder
- Dan Poppy: The context engineering playbook (Claire Gouze), intervju med Claire Gouze i The Analytics Engineering Roundup, dbt Labs, 2. juli 2026.
- Jason Ganz og Benoit Perigaud: Semantic Layer vs. Text-to-SQL: 2026 Benchmark Update, dbt Developer Blog, 7. april 2026.
- Arthur F. Siqueira og andre: On the Limitations of Large Language Models for Conceptual Database Modeling, arXiv, versjon 2, 18. september 2026.
- Juha Korpela: Data Modeling Is Changing: From Design to Discovery, BI-Platform, 1. september 2026.
- Joe Reis: The Mixed Model Arts Manifesto, Practical Data Modeling, 19. august 2026.
- Joe Reis: Why 90% of Data Teams Are Failing at Data Modeling, om pulsundersøkelsen i Practical Data Community i april 2026, Joe Reis på Substack, 15. mai 2026.
- Fivetran: Data warehouse modeling: Star schema vs. OBT, Fivetran-bloggen, 16. august 2022.
- Ralph Kimball og Margy Ross: The Data Warehouse Toolkit, 3rd Edition, Wiley, 2013.
- W. H. Inmon: Building the Data Warehouse, 4th Edition, Wiley, 2005.
Hør hele samtalen med Eystein T. Kleivenes
Hør på podcasten «Datautforskerne», episode 8, der systemarkitekt Eystein T. Kleivenes og Magne Bakkeli snakker om at informasjonsarkitekten er tilbake. Episoden er fra 2024 og er tilgjengelig på Spotify, Apple og Acast.
Forsidebilde: Datamodell-illustrasjon, Tee11/Adobe Stock.
Magne Bakkeli er medgründer og seniorrådgiver i Glitni. Han har over 25 års erfaring med dataplattformer, data governance og dataarkitektur, og ledet Data & Analytics-teamet i PwC Consulting i 12 år. Han har bygget og modernisert dataplattformer i kraft, FMCG, finans og media.