
Innhold
Mer fra Kunstig Intelligens
Datateamets harness og kontekst avgjør mer enn modellen

Kategori: Kunstig Intelligens | Emneknagger: #ai-agenter, #harness, #kontekstlag, #semantisk lag, #dataprodukter
En AI-agent for tallene deres er en språkmodell med lag rundt seg. Datateamet bygger harnesset, og eierne av dataene forvalter konteksten.
Kort fortalt: En AI-agent for virksomhetens tall består av en språkmodell og to lag rundt den. Harnesset styrer arbeidet, og konteksten forteller modellen det den trenger å vite, fra hva ordene betyr til hvordan tallene regnes ut. Modellen er den samme for alle, og datateamet bygger harnesset og konteksten. Hos Data Culture gikk samme modell fra 0 til 92 prosent riktige svar etter hvert som konteksten kom på plass. Anthropics interne analyseagent falt fra rundt 95 til rundt 65 prosent på en måned før vedlikeholdet ble en del av utviklingsarbeidet. Konteksten er data og har flere eiere: domenet eier begrepene, dataproduktet eier definisjonene, og use caset eier spørsmålene og fasiten agenten måles mot.
Språkmodellen er bare én del av en AI-agent som svarer på spørsmål om virksomhetens egne tall. Rundt modellen ligger et program som styrer arbeidet, og en kontekst som forteller modellen det den trenger å vite. Konteksten har to kunnskapslag: ett forklarer hva ordene betyr, og ett vet hvordan tallene regnes ut. Artikkelen følger først ett spørsmål gjennom alle lagene. Deretter ser den på hvem som eier konteksten, og hvordan datateamet holder den ved like.
Hva består en AI-agent for data av?
Det enkleste bildet er en flink nyansatt på første arbeidsdag. Den nyansatte kan mye fra før, men ingenting om akkurat deres virksomhet. Forskjellen er at agenten ikke har noen kollega å spørre, så alt må stå skrevet et sted den kan lese.
| Lag | Hva det er | Som for en nyansatt |
|---|---|---|
| Modellen | Språkmodellen som leser, resonnerer og skriver. Den er lik for alle som bruker den. | Allmennkunnskapen den nyansatte har med seg fra før. |
| Harnesset | Programmet rundt modellen: verktøy, tilganger, minne, kontroll og arbeidsløkka. | Arbeidsplassen: PC-en, adgangskortet, rutinene og lederen som ser over arbeidet. |
| Konteksten | Det modellen får se akkurat nå, hentet fra instruksene til den enkelte, teamet og selskapet og fra kunnskapen om dataene. | Papirene som ligger på pulten når oppgaven starter. |
| Ontologien | Begrepene i virksomheten, hva de betyr og hvordan de henger sammen. | Ordlista som forteller hva «aktiv kunde» betyr hos dere. |
| Semantisk lag | Oppskriften på hvordan hvert nøkkeltall regnes ut i tabellene. | Regnearket økonomiavdelingen har godkjent. |
| Spesialisert agent | Samme modell med verktøy og kontekst for én type oppgave. | Den samme nyansatte, plassert i analyseteamet med analyseverktøyene. |
Hva skjer når noen spør agenten om et tall?
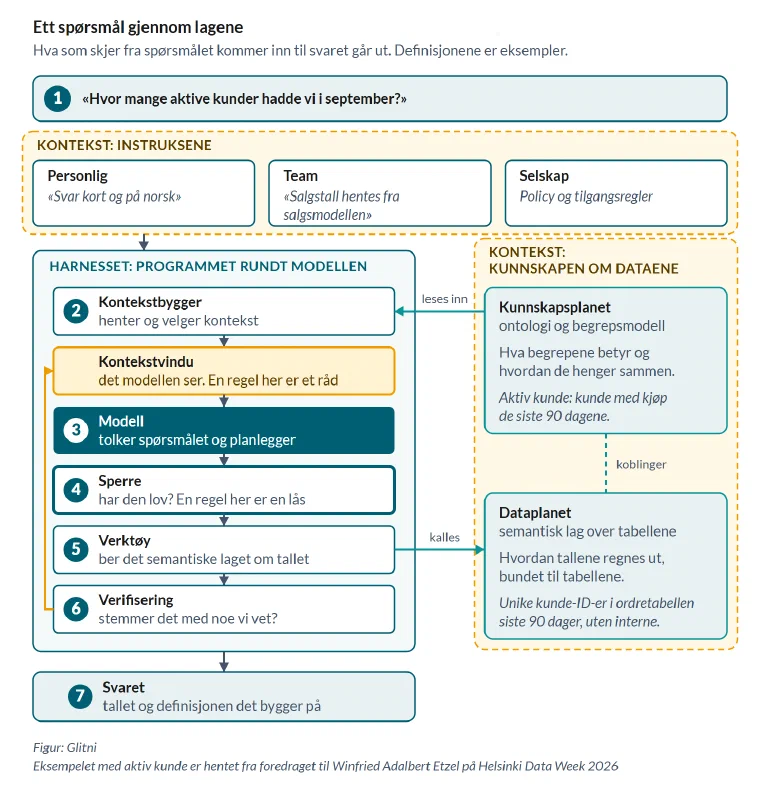
Spørsmålet er «Hvor mange aktive kunder hadde vi i september?». Det ser enkelt ut, men «aktiv kunde» kan bety ulike ting i samme virksomhet. Winfried Adalbert Etzel jobber med data governance og dataforvaltning i Equinor og er vert for podkasten MetaDAMA. På Helsinki Data Week i oktober fortalte han om en bank der ett team regnet en kunde som aktiv etter et kjøp de siste 90 dagene, mens et annet team regnet en åpnet e-post. Begge tallene ble regnet riktig, men de svarte på hvert sitt spørsmål.
- Spørsmålet kommer inn: Brukeren skriver spørsmålet i et chatvindu eller i Slack.
- Harnesset henter kontekst: Det samler instruksene fra brukeren, teamet og selskapet, og slår opp hva «aktiv kunde» betyr hos dere. Begge deler havner i kontekstvinduet, som er det modellen ser.
- Modellen tolker og planlegger: Den forstår at spørsmålet gjelder nøkkeltallet aktive kunder for september, og velger å spørre det semantiske laget framfor å skrive en spørring selv.
- Sperren sjekker tilgangen: Før verktøyet kjører, kontrollerer harnesset at brukeren og agenten har lov til å se tallet.
- Det semantiske laget regner: Verktøyet ber om nøkkeltallet, og laget vet hvilke tabeller, koblinger og filtre som gir riktig tall.
- Verifiseringen kontrollerer: Harnesset sammenligner svaret med noe det vet, for eksempel et spørsmål med kjent fasit eller tallet for forrige måned. Ser noe galt ut, går resultatet tilbake i løkka som ny kontekst.
- Svaret går ut: Brukeren får tallet sammen med definisjonen det bygger på, og kan se hva som er talt.
Hva gjør hvert lag?
Hvert lag har sin egen jobb, og bare modellen er lik for alle. De andre lagene bygger dere selv, eller dere får dem fra en leverandør og fyller dem med kunnskapen om virksomheten.
Modellen
Språkmodellen er den samme for alle som bruker den. Modellen har lest enorme mengder tekst og kan mye om kunder, inntekter og ordre i alminnelighet, men den vet ikke hvordan akkurat dere definerer dem. En bedre modell skriver bedre SQL, men den kan ikke vite det som ikke står skrevet ned noe sted.
Harnesset
Harnesset er programmet rundt modellen. Det kjører arbeidet i en løkke, gir modellen verktøy, bestemmer hva den har lov til, husker mellom øktene, kontrollerer resultatet og setter sammen konteksten før hvert kall. Claude Code og andre kodeagenter er eksempler på et harness rundt en språkmodell.
En regel kan stå to steder. Står den som tekst i konteksten, for eksempel «vis aldri personnumre», er den et råd modellen som regel følger, men kan overse. Står den som kode i harnesset, som en sperre som stopper spørringen, gjelder den hver gang. Dere bør derfor skrive regelen som kode når dere ikke tåler at den brytes.
Konteksten
Konteksten er alt modellen får se i ett kall: instrukser, dokumenter, definisjoner, resultater fra verktøy og samtalen så langt. Harnesset setter den sammen på nytt for hver oppgave, så selve konteksten er ferskvare. Den hentes fra kilder som må forvaltes over tid, og kildene er av to slag.
Det første slaget er instruksene om hvordan agenten skal jobbe. Instruksene ligger på tre nivåer:
- Personlig: egne notater, ønsker og minne.
- Team: felles konvensjoner, maler og arbeidsbeskrivelser.
- Selskap: policy, tilgangsregler og felles retningslinjer.
Det andre slaget er kunnskapen om dataene: hva begrepene betyr, hvordan nøkkeltallene regnes ut, hva tabellene og kolonnene inneholder, og hvorfor et tall har endret seg. Denne kunnskapen hører til de som eier dataene, og den får sin egen seksjon lenger ned.
For begge slag avgjør nivået hvor strengt kilden må styres. Juha-Pekka Joutsenlahti leder arbeidet med datakataloger og er datarådgiver i Solita. I et innlegg på LinkedIn skiller han mellom fire nivåer av kunnskap, fra personlige notater til selskapets felles begreper. Han peker på at personlige notater kveles av byråkrati hvis de styres som felles kunnskap, og at AI handler på det ingen har avtalt, hvis selskapets kunnskap drives som personlige notater. Jo flere som er avhengige av en kilde, desto strengere styring trenger den.
Ontologien og begrepsmodellen
En ontologi beskriver begrepene i virksomheten, hva de betyr og hvordan de henger sammen. Ontologien kan for eksempel si at bedriftskunder og privatkunder begge er kunder, at bare bedriftskunder kan ha salgskontrakter, og at en ordre alltid hører til en kunde. En begrepsmodell er den samme tanken tegnet for mennesker, og ofte utgangspunktet for ontologien. Begge beskriver virksomheten og ikke systemene, så dere kan lage dem før dere har sett på en eneste tabell.
Ontologien hjelper mest der virksomheten bruker ordene annerledes enn ellers. Modellen kjenner den vanlige betydningen av ord som kunde og inntekt fra før, så gevinsten ligger i begrepene dere bruker på deres egen måte.
Ontologien må også passe til dataene. Mark Freeman II har skrevet O’Reilly-boka «Data Contracts» sammen med Chad Sanderson. I en masterclass på Helsinki Data Week fortalte han om en evaluering der han ga agenten Linked Art, en ferdig ontologi for museer, og stilte den spørsmål om databasen til ett bestemt museum. Han ventet at svarene skulle bli bedre, men de falt kraftig, fordi ontologien manglet materialet tre, som museet bruker. Skal agenten regne ut tall, må ontologien dessuten kobles til tabellene. I en studie fra data.world i 2023 stilte forskerne GPT-4 spørsmål om en database fra forsikring, uten å gi modellen eksempler. Den svarte riktig på 16 prosent av spørsmålene rett mot databasen, og på 54 prosent med en ontologi og koblinger til tabellene.
Det semantiske laget
Det semantiske laget sier hvordan hvert nøkkeltall regnes ut: hvilke tabeller som brukes, hvordan de kobles, og hvilke filtre som gjelder. Laget er bundet til dataene, og agenten bruker det som et verktøy. I stedet for å skrive SQL fra bunnen ber agenten om nøkkeltallet «aktive kunder» for september, og laget regner det ut likt hver gang.
Uten beskrivelser og et slikt lag må agenten gjette. Hos analyseselskapet Data Culture filtrerte en agent på statusverdien «Available», som ikke fantes i dataene. Ingen beskrivelse sa at verdien «Open» betydde ledig. Spørringen ga null rader uten feilmelding, og ingenting i svaret varslet om feilen. dbt Labs stilte elleve spørsmål i 2026. Svarene gjennom det semantiske laget i dbt var riktige i 98,2 prosent av tilfellene, mot 90,0 prosent når modellen skrev SQL selv mot de samme tabellene og fikk hele skjemaet som kontekst. Laget kan bare svare på det som er modellert, så presisjonen koster dekning.
Et lag bygget for rapporter sier hvordan tallet regnes ut. Skal agenten forklare tallet, trenger den i tillegg å vite når definisjonen endret seg, og hva tallet ikke må forveksles med.
Spesialiserte agenter
En spesialisert analyseagent bruker samme type modell som alle andre agenter. Forskjellen ligger i harnesset og konteksten. Harnesset gir agenten verktøy som kjører spørringer mot det semantiske laget, bygger og tester dbt-modeller og lager dashbord som kode. Konteksten gir den skjemaet, nøkkeltallene og forretningsreglene. Uten ordliste, semantisk lag og styring flytter en analyseagent bare gjettingen fra brukeren til seg selv.
Hva viser målingene av lagene?
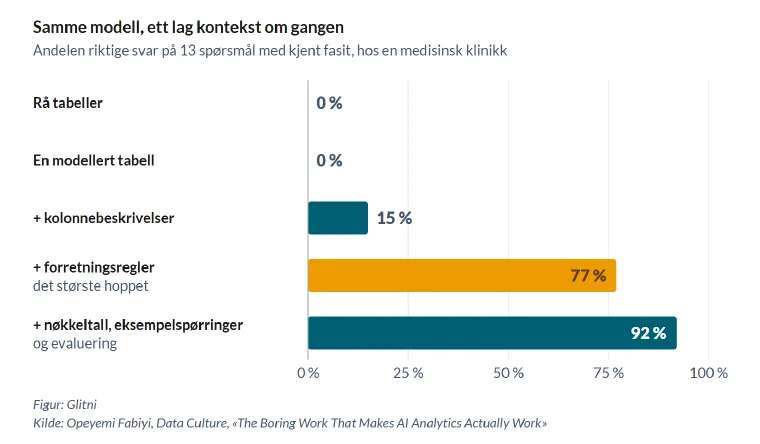
Data Culture bygde en agent for en medisinsk klinikk og stilte den 13 forretningsspørsmål med kjent fasit. Teamet la på ett lag kontekst om gangen og beholdt samme modell hele veien. Med rå tabeller og med én modellert tabell var ingen av svarene riktige. Kolonnebeskrivelser ga 15 prosent, forretningsreglene økte andelen til 77 prosent, og med nøkkeltall, eksempelspørringer og en fast evaluering endte agenten på 92 prosent. I det siste steget rettet teamet også evalueringen. Rundt 23 prosentpoeng av sluttresultatet kom fra svar som hele tiden var riktige, men som den gamle evalueringen avviste på grunn av små forskjeller i formatet. Den største forbedringen kom da forretningsreglene ble skrevet ned, altså kunnskap som før bare fantes i hodene til analytikerne. Vi har skrevet mer om forsøket i artikkelen om metadata og ontologi.
Tre spørsmål viser hvor langt dere har kommet med lagene:
- Har dere skrevet ned hva de viktigste begrepene betyr, og er de som bruker dem, enige?
- Er hvert nøkkeltall definert ett sted, med en eier som kan rette det?
- Står reglene dere bryr dere mest om, som kode i harnesset, eller bare som tekst?
Lagene rundt modellen avgjør svarene, og de bygges av folk som kjenner virksomheten.
Hvorfor avgjør harnesset og konteksten mer enn modellen?
Da Anthropic lanserte sin interne analyseagent, svarte den riktig på rundt 95 prosent av spørsmålene i testsettet. En måned senere svarte den riktig på rundt 65 prosent. Agenten leste skills som beskrev en datamodell som endrer seg hver dag, men teamet vedlikeholdt dem ennå ikke som en del av utviklingsarbeidet.
Anthropic forteller dette selv i en artikkel om hvordan datateamet deres lar Claude svare på analysespørsmål fra resten av selskapet. Skills er instruksjoner i markdown som agenten henter ved behov. Uten skills kom agenten aldri over 21 prosent riktige svar. Med skills lå den over 95 prosent, og rundt 99 i enkelte områder. Agenten falt til 65 prosent før teamet begynte å behandle vedlikeholdet som en del av utviklingsarbeidet.
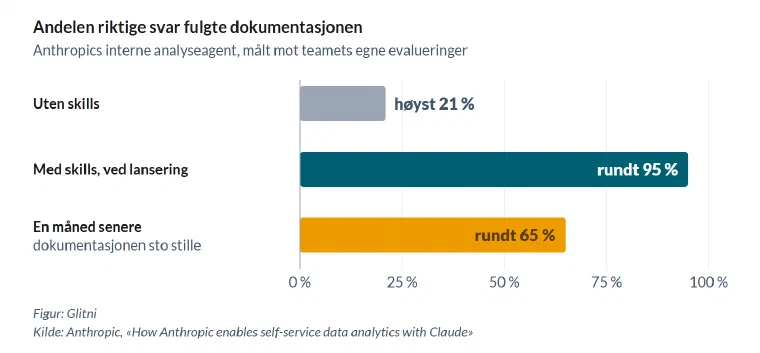
Tallene gjelder én agent i ett selskap, men de sier det viktigste i kort form. Teamet tok agenten fra 21 til over 95 prosent med kontekst de skrev selv, og uten vedlikehold falt den til 65.
Xavier Gumara Rigol leder dataavdelingen i Manychat og skriver nyhetsbrevet Data as a Product Driver. I essayet om harness for datateam deler han harnesset i seks deler: kontekstinjeksjon, skills, MCP-servere, hooks, observerbarhet og underagenter.
Robert Sahlin har permisjon fra Nordnet og bygger opp sitt nye selskap, Supercargo. Han har skrevet om hvordan dataplattformteamet i Nordnet tester agenter mot ekte forretningsspørsmål på et produksjonsvarehus, med to ledetekster. Den ene er minimal. Den andre forteller agenten hvor forretningsbegrepene og kolonnebeskrivelsene står, og hvordan den skal bruke dem. Sahlin kaller det sitt mest overraskende funn så langt: en mellomstor modell med den veiledende ledeteksten gjør det ofte bedre enn en større modell med den minimale. dbt Labs viser at begge deler teller. Nyere modeller økte andelen riktige svar fra tekst til SQL fra 32,7 til 64,5 prosent. Etter at en språkmodell hadde bygd tre nye tabeller i dbt, kom den samme nye modellen til 90 prosent.
Hos kodeagentene er bildet blandet. LangChain flyttet kodeagenten sin fra 52,8 til 66,5 prosent løste oppgaver på testen Terminal Bench 2.0 uten å bytte modell. I studien HarnessTax fra UC Berkeley betydde valget av kodeverktøy lite for hvor mange oppgaver som ble løst, men mye for hva jobben kostet. Begge målingene gjelder kode og ikke analyse.
For et datateam ligger forskjellen i det teamet selv legger rundt modellen, ikke i hvilket verktøy de har valgt.
Hvorfor er data vanskeligere enn kode for en agent?
Kode kan testes isolert, og en feil gir som regel en feilmelding. I data kan en spørring kjøre feilfritt og likevel gi feil tall, slik spørringen etter «Available» gjorde. Anthropic skriver at et analysespørsmål ofte har ett riktig svar fra én riktig kilde, og at det ikke finnes noen sikker måte å bevise at svaret er riktig. De kaller derfor treffsikkerhet i analyse et problem med kontekst og kontroll, ikke med kodegenerering.
Gumara Rigol beskriver fire problemer data har, som programvare ikke har:
- Tilstand: data går gjennom lag der de slås sammen, filtreres og aggregeres. En agent kan skrive kode som kjører uten feil og likevel lagrer helt gale data, fordi den har misforstått hvordan dataene samles inn og transformeres.
- Miljø: få datateam har et utviklingsvarehus med realistiske testdata. Uten et trygt sted å teste, tester agenten like blindt som teamet.
- Metadata: folk vet ofte hva en tabell eller en kolonne betyr, uten at det står skrevet noe sted. Et felt kan hete det samme som det brukeren spør om, og likevel bety noe annet. Da skriver agenten en spørring som er teknisk riktig og svarer på feil spørsmål.
- Kvalitet: en godt skrevet sammenføyning kan likevel gange opp rader og bryte en primærnøkkel lenger ned i flyten.
Ingen av de fire løses av en bedre modell i dag. Alle fire er arbeid datateamet kjenner fra før.
Hvorfor hjelper det ikke å gi agenten tilgang til alt?
Fordi flaskehalsen er struktur, ikke tilgang. Anthropic prøvde å peke agenten mot all SQL teamet hadde skrevet, slik de forteller i artikkelen om analyseagenten. De ga den tilgang til å søke i tusenvis av tidligere spørringer fra dashboards, transformasjoner og analytikernes notatbøker, og sjekket i sporene fra kjøringene at den leste dem. Andelen riktige svar flyttet seg mindre enn ett prosentpoeng.
Svaret fantes i materialet for rundt 80 prosent av spørsmålene agenten bommet på. Agenten så det, men brukte det ikke. Ifølge Anthropic manglet agenten struktur, altså koblingen fra spørsmålet til riktig enhet i dataene. Etter vår vurdering er det nettopp den koblingen ontologien og det semantiske laget gir. Anthropic prøvde også å la en språkmodell lage definisjonene av nøkkeltall fra tabellene og spørringsloggene. Resultatet var dårligere enn et mindre sett definisjoner som folk hadde laget. Anthropic holder likevel ikke agenten unna dokumentasjonen. Rådet deres er at Claude skriver dokumentasjonen, mens et menneske eier definisjonen av hva nøkkeltallet betyr.
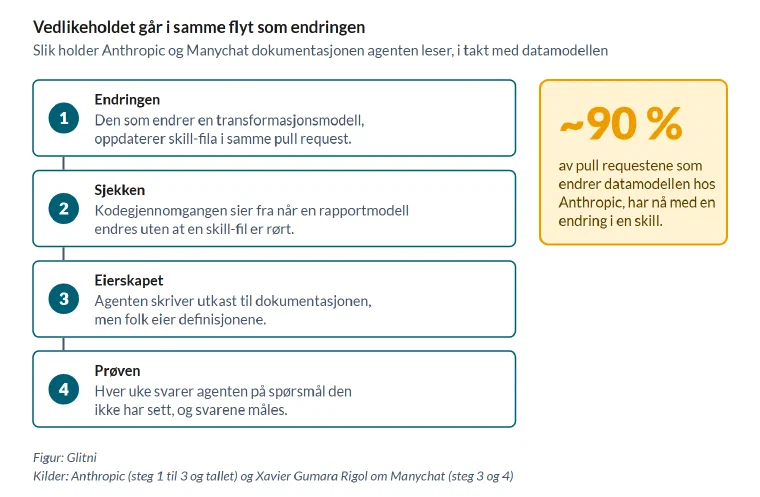
Manychat bygger på samme prinsipp. En skill lager metadata for hver tabell ut fra SQL-en, men folk eier teksten, og ny kunnskap kommer inn som en pull request som gjennomgås som kode. Et spørsmål om markedskampanjer laster bare inn markedsområdet. Agenten spør først et lite sett godkjente datasett som noen står bak. Hver uke får den en prøve med spørsmål den aldri har sett, og det semantiske laget deles med BI-verktøyet. Agenten svarer med kildene, hvor sikkert svaret er, SQL-en og navnet på analytikeren man kan spørre.
Agenten trenger færre og bedre beskrevne data, ikke mer av alt.
Hvem eier hvilken del av konteksten?
Konteksten har flere eiere. Eierne av harnesset eier instruksene om hvordan agenten skal jobbe. Kunnskapen om dataene eies der dataene eies: i domenet, i dataproduktet og i use caset der dataproduktet brukes.
Gumara Rigol tegnet harnesset som ringer rundt modellen i et webinar i Data & AI Product Management Community 19. oktober. Innerst ligger modellen og verktøyet leverandøren har bygd rundt den, for eksempel Claude Code. Utenpå ligger tre ringer som selskapet, teamet og den enkelte eier, og de svarer til de tre nivåene instruksene hentes fra. De ytre ringene kan legge til, men aldri ta bort, så en tilgangsregel fra selskapet gjelder uansett hva den enkelte har satt opp selv.
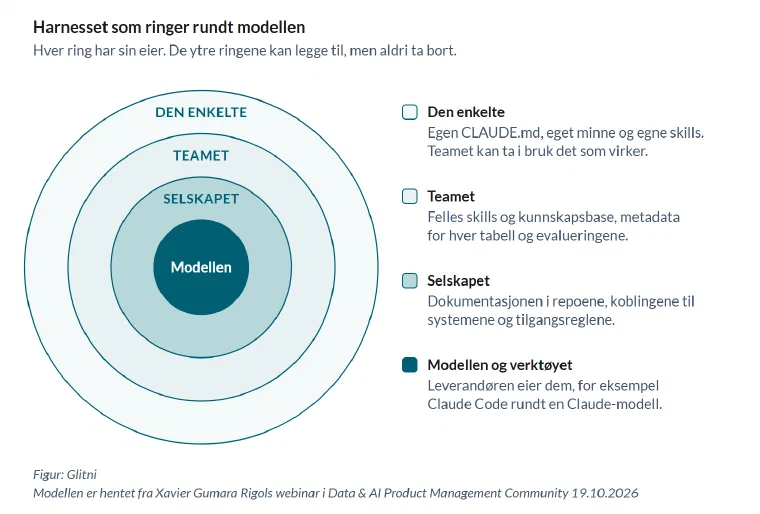
Selskapets ring har dokumentasjonen i repoene, koblingene til systemene og tilgangsreglene. Teamets ring har de felles skillene, en felles kunnskapsbase, metadata for hver tabell og evalueringene. Ytterst har den enkelte sin egen CLAUDE.md, sitt minne og sine egne skills. En skill kan flytte innover, og slik kan teamet ta i bruk skillen én ivrig medarbeider har laget for seg selv.
Ringene viser hvem som eier oppsettet. Kunnskapen om dataene trenger en inndeling til, og den følger domenene og dataproduktene datateamet forvalter:
| Nivå | Hva som forvaltes felles | Hvem som eier det | Når det endres |
|---|---|---|---|
| Domenet | Begrepene og hva de betyr, begrepsmodellen eller ontologien, og forretningsreglene som gjelder for alle som bruker dataene. | Dataeieren i domenet, med dataforvalteren som tar det daglige arbeidet. | Når virksomheten endrer hva et begrep betyr. |
| Dataproduktet | Beskrivelsen av tabeller og kolonner, nøkkeltallene i det semantiske laget, datakontrakten, kvalitetsreglene og endringsloggen for definisjonene. | Eieren av dataproduktet og teamet som bygger det. | I samme pull request som datamodellen. |
| Use caset | Spørsmålene agenten skal svare på, hvilke dataprodukter den får bruke, instruksene for akkurat denne bruken og evalueringssettet med fasit. | Den som eier use caset, for eksempel lederen som tar beslutningene, sammen med analytikerne som kjenner spørsmålene. | Når spørsmålene eller beslutningene endrer seg. |
Domenet og dataproduktet beskriver dataene likt for alle som spør, mens et use case handler om én bestemt bruk. Yali Sassoon i Snowplow forklarer forskjellen på semantisk lag og kontekstlag i et essay, og han sier selv fra om at Snowplow bygger et kontekstlag for kunder. Det semantiske laget beskriver fortiden likt for alle som spør, skriver han, mens kontekstlaget er skrevet for én agent som skal handle godt i én situasjon. Verken domenet eller dataproduktet kan eie den konteksten, fordi de ikke vet hvilken beslutning svaret skal brukes til.
Regelen fra Joutsenlahti sier hvor strengt hvert nivå må styres. Begrepene i domenet brukes av alle dataproduktene og alle use casene, så dataeieren må godkjenne en endring der. Beskrivelsene i dataproduktet følger datamodellen og endres i samme pull request. Instruksene i et use case kan endres raskest, av de som bruker svarene. Trenger flere use caser den samme forklaringen, flytter den inn i dataproduktet eller domenet, slik en skill flytter fra den enkelte til teamet.
Etzels bank viser hva som skjer når grensene ikke er avklart: to team regnet aktive kunder på hver sin måte, og begge tallene var riktige. Vårt råd er at domenet eier definisjonen. Trenger et use case en annen definisjon, får den et eget navn i domenet, og ingen agent får en egen variant i instruksene sine.
Mange datateam får agenten levert av plattformen de har, med et eget semantisk lag og egne AI-funksjoner. Da ligger mer av den innerste ringen hos leverandøren, men eierne av konteksten er de samme. Plattformen kan lage utkast til beskrivelser og definisjoner, men domenet eier hva begrepene betyr, dataproduktet eier hvordan nøkkeltallene regnes ut, og use caset eier evalueringssettet og fasiten agenten måles mot.
Står konteksten bare i oppsettet til én person, har teamet ikke et harness. Da har det én person med et godt oppsett.
Hvordan holdes konteksten ved like?
I samme flyt som dataene den beskriver, ellers er den feil i løpet av uker. Slik falt Anthropics agent fra 95 til 65 prosent. Teamet la derfor skill-filene i samme repo som transformasjonsmodellene. Endrer noen en modell, oppdaterer de dokumentasjonen i samme pull request, og en sjekk i kodegjennomgangen sier fra når en rapportmodell endres uten at en skill-fil er rørt. Nå endrer rundt 90 prosent av pull requestene mot datamodellen også en skill.
Vanskeligst å holde ved like er forklaringen på hvorfor et tall endret seg, fordi den sjelden blir data. Analyseselskapet Tasman bruker et tenkt kaffeselskap med abonnement som eksempel i en gjennomgang av hvordan et kontekstlag bygges. I eksempelet var frafallet av abonnenter 9,4 prosent i mars, mot et snitt på 3,1 prosent. Agenten fikk tallet riktig fra det semantiske laget, men forklaringen feil. Årsaken var en migrering av betalingsløsningen som hadde registrert rundt 1 900 pausede abonnementer som oppsagt, og det visste bare analytikeren.
Tasman gir forklaringene tre faste steder. Hendelser som migreringer, kampanjer og driftsstans står i en tabell med dato, nøkkeltallene de påvirker og en eier, så agenten kan koble dem mot tallene. Hver versjon av en definisjon står i en endringslogg med datoen den gjelder fra. Begrunnelsene står i korte beslutningsnotater i markdown i samme repo som dbt-modellene, og et notat redigeres aldri, men erstattes av et nytt. Forklaringene skrives i pull requesten eller etter en hendelse, så lenge noen fortsatt husker hvorfor. I eksempelet tok det om lag en time fordelt over fire måneder å skrive ned det agenten trengte for å forklare frafallet riktig. Endringsloggen hører til dataproduktet som eier nøkkeltallet, mens eieren av en hendelse står i tabellen.
Vedlikeholdet går begge veier. Anthropic rydder også bort deler av skillene når nyere modeller ikke lenger gjør feilene de var skrevet for å hindre. Kommer det en ny modell, bør evalueringssettet kjøres på nytt før den tas i bruk, for den kan svare bedre eller dårligere på akkurat de spørsmålene teamet får. Endrer virksomheten hva en aktiv kunde er, må definisjonen i domenet, regnestykket i dataproduktet og evalueringen i hvert use case endres sammen.
Ingen har målt hvor mye tid vedlikeholdet tar. Gumara Rigol anslår at han selv bruker kanskje 20 prosent av tiden sin på harnesset, og at andelen varierer. Analytikerne hans bruker mye tid på kontekst, metadata og evaluering.
I essayet nevner Gumara Rigol to grep som gjør jobben lettere. Hooks er sjekker som står i veien for en handling, og agenten kan ikke la være å kjøre dem. Det er regler som kode og ikke som tekst. Har teamet datakontrakter, er det enkelt å la hooks håndheve dem. Og en egen underagent bør vurdere om SQL-en svarer på spørsmålet som ble stilt. Han kaller det juks å la agenten som skrev spørringen, vurdere den selv. Anthropic anbefaler i sine nyeste råd om agentarkitektur å slå rutere, planleggere og fagagenter sammen til én agent som henter skills ved behov. Men de regner fortsatt kontroll av arbeidet som en oppgave underagenter gjør godt.
Harnesset løser likevel ikke alt. Ingen av de seks delene gir agenten et trygt varehus å teste i, med ferske og realistiske data. Et slikt varehus må bygges som en egen investering.
Priser dere bare inn byggingen av agenten, har dere priset inn de første 95 prosentene og ikke månedene etterpå.
Hvor bør et datateam begynne?
Med ett domene, ett dataprodukt og ett use case, og én navngitt eier for hvert. Skriv definisjonene for de mest brukte tabellene i dataproduktet, gi dem en eier, og legg skill-fila i samme repo som modellene, med en sjekk i kodegjennomgangen. Skriv ned spørsmålene use caset skal svare på, med fasit for noen titalls av dem. Anthropic anbefaler en lignende start og skriver at det meste av gevinsten kommer fra en håndfull godkjente datasett, noen titalls evalueringer og en tynn skill som peker videre. Kjør evalueringene hver uke, så ser dere når dokumentasjonen begynner å henge etter datamodellen.
Veien videre avhenger av hvordan teamet jobber i dag. Driver teamet data som produkt, med eiere, dokumentasjon og datakontrakter, har det kommet langt. Da gjenstår mest å bruke den samme praksisen rundt agenten. Leverer teamet fortsatt rapporter på bestilling som en støttefunksjon, må det bygge produktdisiplinen og harnesset samtidig. For et slikt team mener vi det raskeste grepet er å skrive ned det som i dag bare finnes i hodene til folk, slik forretningsreglene gjorde utslaget hos Data Culture. Vi har skrevet om det arbeidet i verdien av metadata og i guiden til dataprodukter.
Fem spørsmål fra Gumara Rigol viser om et datateam er klart:
- Finner agenten de riktige dataene?
- Står metadata og definisjoner ved hvert datasett?
- Finnes det tilgangsregler agenten følger?
- Finnes det tester og evalueringer?
- Finnes det et trygt sted å prøve, med et utvalg av dataene?
Vi vil legge til to spørsmål, fordi Anthropic-tallene og eierskapet til konteksten gjør dem nødvendige. Hvem oppdaterer skill-fila neste gang noen endrer en modell i dbt? Og hvem eier fasiten agenten måles mot i hvert use case? Er svaret ingen, har dere en demo, ikke en analyseagent.
Vanlige spørsmål om harness og kontekst for datateam
Hva er et harness for en AI-agent? Et harness er programmet rundt modellen. Det gir modellen kontekst, skills og verktøy, kjører sjekker, fører logg og lar underagenter kontrollere arbeidet. For et datateam består det mest av metadata, definisjoner, evalueringer og eierskapet til dem.
Hva er forskjellen på harnesset og konteksten? Konteksten er det modellen får vite før den svarer: instrukser, definisjoner, beskrivelser av dataene og resultater fra verktøy. Harnesset er hele oppsettet rundt modellen: det setter sammen konteksten, gir modellen skills og verktøy, kjører sjekker og lar underagenter kontrollere arbeidet.
Hvem eier konteksten til en AI-agent for data? Konteksten eies der dataene eies. Domenet eier begrepene og forretningsreglene, dataproduktet eier beskrivelsene, nøkkeltallene og endringsloggen, og use caset eier spørsmålene agenten skal svare på, fasiten den måles mot og instruksene for akkurat den bruken. Selskapet eier tilgangsreglene, og de gjelder uansett.
Hva er forskjellen på en ontologi og et semantisk lag? Ontologien beskriver hva begrepene i virksomheten betyr og hvordan de henger sammen, uavhengig av systemene. Det semantiske laget sier hvordan hvert nøkkeltall regnes ut i tabellene. Agenten leser ontologien som kontekst, og kaller det semantiske laget som et verktøy når den trenger tallet.
Hjelper det å bytte til en bedre språkmodell? Ja, men modellen alene stanser halvveis. dbt Labs målte at nyere modeller økte andelen riktige svar fra tekst til SQL fra 32,7 til 64,5 prosent. Den samme modellen kom til 90 prosent først da dataene var modellert i tre nye tabeller i dbt. Robert Sahlin skriver at en mellomstor modell med god veiledning ofte gjør det bedre enn en større modell uten.
Hvor mye tid går med til å holde harnesset og konteksten ved like? Det finnes ingen målt andel. Xavier Gumara Rigol leder dataavdelingen i Manychat og anslår at han selv bruker kanskje 20 prosent av tiden sin på det. Anthropic så andelen riktige svar falle fra rundt 95 til rundt 65 prosent på en måned, før de la dokumentasjonen i samme repo som datamodellen.
Kilder
- Anthropic: How Anthropic enables self-service data analytics with Claude, 3. juni 2026. Figur 3 og tallet i figur 5 bygger på tallene herfra.
- Anthropic: Building agents: When to fold subagents into your main agent loop, 22. oktober 2026.
- Opeyemi Fabiyi: The Boring Work That Makes AI Analytics Actually Work, Data Culture, 28. april 2026. Figur 2 bygger på tallene herfra.
- Jason Ganz og Benoit Perigaud: Semantic Layer vs. Text-to-SQL: 2026 Benchmark Update, dbt Labs, 7. april 2026.
- Juan Sequeda, Dean Allemang og Bryon Jacob: A Benchmark to Understand the Role of Knowledge Graphs on Large Language Model’s Accuracy for Question Answering on Enterprise SQL Databases, arXiv, november 2023.
- Winfried Adalbert Etzel: From Handover to Hangover, foredrag på Helsinki Data Week, 27. oktober 2026.
- Mark Freeman II: masterclass om datakontrakter og semantikk på Helsinki Data Week, 26. oktober 2026, med workshop-repoet.
- Juha-Pekka Joutsenlahti: innlegg om fire nivåer av kunnskap for AI, LinkedIn, 8. oktober 2026.
- Xavier Gumara Rigol: Harness Engineering for Data Teams, Data as a Product Driver, 22. september 2026.
- Xavier Gumara Rigol: Building an AI Harness for Your Data Team, webinar i Data & AI Product Management Community, 19. oktober 2026, bare for medlemmer. Figur 4 bygger på modellen herfra.
- Robert Sahlin: How do you know if the analytics agent is right?, Data Platform Engineering, 29. august 2026.
- Yali Sassoon: A semantic layer is not a context layer, Data Creation, juli 2026.
- Tasman Analytics: How to Build a Context Layer (Because You Cannot Buy One), juli 2026.
- Vivek Trivedy: Improving Deep Agents with harness engineering, LangChain, 17. februar 2026.
- Pan, Yang, Arabzadeh, Chiang, Stoica og Zaharia: HarnessTax, UC Berkeley, september 2026.