
Deler av artikkelen bygger på samtalen med Bjarte Tolleshaug, sjefskonsulent og fagleder for skyteknologi og data i Experis Bergen, i episode 20 av podkasten Datautforskerne.
Kort fortalt: Start dataforvaltningen med ett domene der grensene er klare, eieren er villig og problemet er ekte. Bygg ett eller to kritiske dataprodukter der, og lag malene mens du gjør det. Eieren trenger mandat, et formål folk forstår og tid til jobben. Naboene skriver du ned som hypoteser, og verktøy kjøper du først når behovet vokser.
Vi i Glitni jobbet i år med en stor norsk produksjonsvirksomhet som kjører prognosemodeller i daglig drift. Avanserte analyser ligger til grunn for beslutninger med stor økonomisk effekt. Likevel hadde ingen av de viktigste dataområdene formelt dataeierskap, kvalitetsavtaler eller datakontrakter da vi startet.
Problemet var ikke evne. Det var forvaltningslaget under: laget som gjør at databruken er trygg, sporbar og uavhengig av enkeltpersoner.
Slik starter det ofte. Noen tegner et rammeverk for hele virksomheten: policyer, prinsipper, et råd, en komité. Et halvt år senere henger rammeverket på veggen, og dataene forvaltes som før.
De som kommer videre, starter mindre. De velger ett domene, peker ut én eier, bygger ett eller to konkrete dataprodukter, og lar resten følge etter. Denne artikkelen er den praktiske oppskriften: hvordan du kommer i gang med dataforvaltning som virker, uten å vente på den store planen.
Hvorfor domener og eiere må komme først
Data governance feiler oftest fordi det forblir abstrakt. Et rammeverk uten et sted å lande er bare ord.
Domener gir governance et sted å lande. Et domene er et avgrenset område der data brukes og forvaltes for et felles formål. En dataeier er en leder med reell myndighet i det forretningsområdet. Det skal ikke være en IT-rolle.
Den beste dataeieren er den som har mest å tape på at dataene er feil, og mest å vinne på at de er gode.
Domener defineres etter bruk, ikke etter organisasjonskartet. To avdelinger kan dele data, og samme datasett kan brukes mange steder. Men eierskapet må være entydig. Noen må eie helheten, selv om mange bruker delene.
Dette er ikke en norsk oppfinnelse. Domain-driven design har i over tjue år snakket om bounded context: at grensene rundt et område trekkes ut fra hva det betyr i forretningen, ikke ut fra hvem som sitter hvor. Data mesh bygger videre på dette og gjør domenet til enheten for dataeierskap. Vi gjør det samme. Vi bare starter med å spørre hvor de daglige beslutningene tas.
Når du ikke kan definere alle domenene
I teorien kartlegger du hele virksomheten, deler den i rene domener og peker ut en eier for hvert. I praksis går det sjelden slik i en kompleks organisasjon. Grensene er uklare, eierskapet overlapper, og hvis du venter på den komplette modellen, venter du for alltid.
Da gjør du det motsatte. Du velger ett eller to domener og starter der.
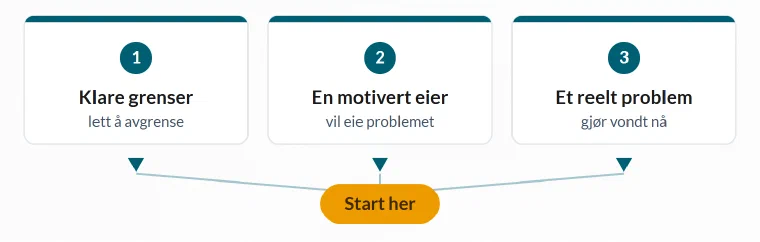
Tre kriterier avgjør hvilke:
- Klare grenser. Domenet må kunne avgrenses uten endeløs diskusjon om hvor det slutter.
- En motivert eier. Det må finnes en leder som har mest å tape på dårlige data her, og som vil eie problemet. Uten en villig eier blir resten teori.
- Et reelt problem. Eierskapet må løse noe som gjør vondt nå. Et område der dårlig datakvalitet blokkerer resultater, eier seg nesten selv, fordi eieren ser verdien med en gang.
Tre spørsmål hjelper deg å finne det. Hvilke tall er det som stadig kommer opp i ledermøtene? Hvor mange timer går med til å rette de samme feilene om igjen? Og hvis én datakilde forsvant i en uke, hva ville stoppe opp? Domenet svarene peker mot, er som regel der du bør begynne.
Velg domenet der de tre kriteriene møtes. Det er her du får momentum, og momentum tar arbeidet videre til neste domene.
Nabodomener er hypoteser
Idet du starter med ett domene, møter du kantene. Domenet får data fra et annet sted. Det leverer data videre. Det deler definisjoner med naboen. Du kan ikke late som om disse koblingene ikke finnes, men du skal heller ikke prøve å eie dem ennå.
Skriv dem ned som hypoteser i stedet.
«Vi tror dette datasettet eies av domene X.» «Vi tror dette nøkkeltallet kommer fra Y.» «Vi tror disse to avdelingene mener det samme med begrepet kunde, men vi har ikke verifisert det.»
Et eksempel fra oppdraget, anonymisert: samme nøkkeltall fantes i flere ulike kildeserier, uten at noen sikret at riktig serie ble brukt. En feil i én kildeserie forplantet seg helt inn i beslutninger lenger ned i verdikjeden. Slike funn er ikke feil i metoden. De er kartet over hvor domene nummer to og tre skal gå.
Hypotesene gjør to ting. De hindrer at du later som om verden er enklere enn den er. Og de gir deg en prioritert liste over hvor du utvider neste gang, basert på avhengigheter i stedet for gjetning.
Ikke alle data er like
Spør tre avdelinger hva en kunde er, og du får tre svar. Salg teller én kunde per kontaktperson de snakker med. Økonomi teller per organisasjonsnummer som faktureres. Support teller per sak. Alle har rett innenfor sitt eget domene. Problemet oppstår den dagen tallene skal møtes i én rapport, og ingen blir enige om hvilket som er riktig.
Grunnen er at data spiller ulike roller, og rollene har ulike forvaltningsbehov. DAMA-DMBOK bygger på Malcolm Chisholms taksonomi for å skille typene. Forenklet til tre som betyr noe når du skal forvalte:
Grunndata, altså master- og referansedata. Kjerneenhetene og kodene alle deler: kunde, produkt, leverandør, ansatt, lokasjon, og kodeverk som land, valuta og kontoplan. De to er beslektet, men ikke like: masterdata er enhetene som endrer seg over tid og må versjoneres, som at en kunde flytter eller et produkt utgår, mens referansedata er de stabile kodeverkene. DAMA er utvetydig: begge «belong to the organization» og må kunne deles på tvers. Dette er dataene som ikke eies naturlig av ett enkelt domene.
Transaksjonsdata. Hendelsene og registreringene fra driften: ordre, målinger, transaksjoner. De eies naturlig av domenet som produserer dem.
Analyse- og avledede data. Aggregater, nøkkeltall, prognoser, rapporter. De eies av domenet som lager dem, men arver tilliten fra dataene de bygger på. Er kilden upålitelig, er prognosen det også.
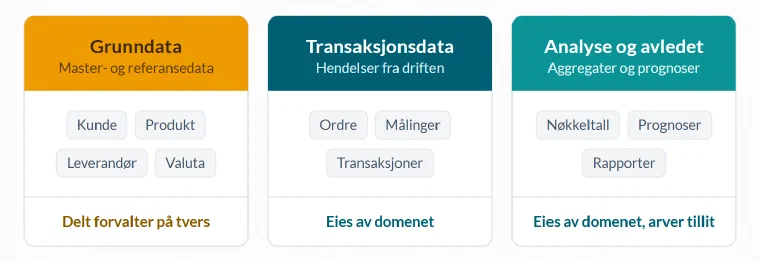
Dette avgjør hvor lett «ett domene, én eier» lar seg gjennomføre. Transaksjonsdata og avledede data passer modellen uten videre. Grunndata gjør det ikke. Lar du hvert domene definere kunde for seg selv, ender du med de samme siloene du prøvde å unngå, bare med tydeligere eierskap inni hver silo. DAMA sier det presist om referansedata: nøkkelen er «organizational willingness to relinquish local control of shared data».
I praksis betyr det at grunndata får en utpekt forvalter på tvers av domenene, mens domenene som bruker dem har bruksrett, ikke definisjonsmakt. Salg kan bruke kundebegrepet, men ikke finne opp sitt eget. Dette er like mye politikk som fag. Noen må gi slipp på lokal kontroll, og det skjer ikke uten en eier med mandat til å bestemme.
Konsekvensen for rekkefølgen: start lite på domener og dataprodukter, men de få felles spillereglene for grunndata må komme parallelt med det første domenet, ikke etterpå. En delt definisjon av de mest sentrale begrepene, og en avklaring av hvem som forvalter dem. Start lite på utførelsen, ikke på prinsippene.
Et tegn på at du har et grunndataproblem: samme begrep gir ulike tall i ulike rapporter, og dere bruker det månedlige møtet på å krangle om hvilket tall som er riktig, i stedet for hva tallet betyr.
Fra eierskap til dataprodukt: start med ett eller to
Eierskap blir først virkelig når det fester seg til noe konkret. Det konkrete er dataproduktet.
Et dataprodukt er ikke en tabell eller en rapport. Det er et datasett som forvaltes som et produkt: det har en eier, et tydelig formål, kjente konsumenter, en kontrakt på hva som leveres, og en kvalitet det står inne for. Forskjellen på et datasett og et dataprodukt er forvaltning.
Ikke prøv å gjøre alt om til dataprodukter på en gang. Velg de ett eller to mest kritiske i domenet du startet med. Kritisk betyr to ting: mange er avhengige av det, og det koster mye når det er feil. Det er der forvaltning betaler seg først.
Tenk MVDP, et minimum viable data product. Det minste produktet som er forvaltet:
- Eier og formål. Hvem eier det, og hvilket behov dekker det?
- Datakontrakt. Hva leveres, i hvilket format, hvor ofte, med hvilken kvalitet?
- Dokumentasjon. Hva betyr feltene, hvor kommer de fra, hvordan tolkes de?
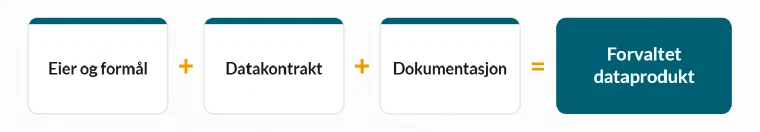
Når det første dataproduktet står, har eieren noe håndfast å forvalte, og resten av virksomheten har et eksempel å peke på. Det er lettere å forklare hva dataforvaltning er med ett ferdig dataprodukt enn med ti sider policy.
Malverk slår engangsleveranser
Det første dataproduktet er ikke målet. Malen er.
Mens du bygger de første ett eller to dataproduktene, bygger du samtidig malverket som gjør det neste raskere: en datakontrakt-mal, et dataprodukt-canvas, en enkel rolle- og ansvarsmal. Første gang tar det tid, fordi du finner ut hva malen skal inneholde. Andre gang fyller du den ut. Tiende gang er den en vane.
Dette er forskjellen på en leveranse og en evne. En engangsleveranse gir deg ett godt dataprodukt. Et malverk gir deg en måte å lage dem på. Det er evnen som skalerer, ikke det enkelte produktet.
En god datakontrakt-mal tvinger fram de riktige spørsmålene: Hvem er produsent og konsument? Hvilke felt, og hva betyr de? Hvor ofte oppdateres dataene, og hva er kravet til ferskhet? Hvilke kvalitetsdimensjoner gjelder, og hva er terskelen? Hva skjer ved en bruddendring, og hvordan varsles konsumentene? Hvordan versjoneres kontrakten?
Slik ser en kontrakt ut i praksis: ordretabellen oppdateres hver natt innen klokken seks, med maks 0,1 prosent manglende rader. Brytes løftet, varsles konsumentene før de rekker å bygge videre på et gammelt grunnlag. Datakontrakter har fått et eget fagspråk de siste årene, blant annet gjennom Andrew Jones’ arbeid og den åpne standarden ODCS, Open Data Contract Standard.
Et råd: la den som skal forvalte dataene fylle ut malen første gang, ikke en sentral funksjon. Malen skal inneholde domenets kunnskap, ikke en arkitekts antakelser.
Enkel tooling først, utvid når behovet vokser
Den dyreste feilen i tidlig dataforvaltning er å kjøpe verktøy før du har noe å forvalte.
Start enkelt. Domeneoversikten kan leve i et regneark. Datakontraktene og begrepsdefinisjonene kan ligge som dokumenter eller i en wiki, versjonert i samme repo som koden, og håndheves med enkle tester i dataflyten, for eksempel dbt-tester, lenge før du trenger egne kontraktsverktøy. Katalogen over de første dataproduktene kan være en enkel liste. Poenget i starten er ikke verktøyet, det er at noen eier innholdet.
Utvid når den manuelle løsningen begynner å koste mer enn den sparer:
- Datakatalog, for eksempel Collibra, Atlan, DataHub eller OpenMetadata, når antall dataprodukter og brukere gjør manuell oversikt uholdbar, og folk bruker tid på å lete etter hva som finnes og hva det betyr.
- Observability og automatisk kvalitetsovervåking når antall kontrakter gjør manuell oppfølging av ferskhet og kvalitet for tungt, og dere oppdager brudd for sent.
- Lineage når dataflyten er kompleks nok til at ingen lenger har hele bildet i hodet, og en feil ett sted forplanter seg uten at noen ser hvor.
Verktøyet skal følge modenheten, ikke skape den. En datakatalog løser ingenting hvis ingen eier dataene som skal stå i den. Vi har sett kataloger til millioner stå halvfylte fordi eierskapet aldri kom på plass først.
Slik blir eierskapet operativt
Eierskap på papiret endrer ingenting. En dataeier som er utpekt i et dokument, men ikke gjør noe annerledes, er like lite verdt som intet eierskap. Jobben er å gjøre eierskapet operativt.
Bjarte Tolleshaug setter opp tre krav som må være på plass samtidig før eierskapet blir noe mer enn ord. Eieren må ha et reelt mandat, altså myndighet til å bestemme og til å rydde opp når noe går galt. Uten mandatet blir alt du ber om stående som høflige oppfordringer, og høflige oppfordringer taper mot alt annet folk har på bordet. Formålet må sitte hos dem som skal gjøre jobben. Skjønner de ikke hvorfor dataene må være riktige, har de ingen grunn til å prioritere arbeidet. Og kapasiteten må finnes. Dataeier og dataforvalter er i praksis biroller på fem til femten prosent lagt oppå en full jobb, og det som haster vinner over det som er viktig. Mangler ett av de tre kravene, stopper arbeidet, uansett hvor godt rammeverket er skrevet.
Fem grep gjør det:
Skill rollene. Dataeier beslutter: hvordan data tolkes, hvem som har tilgang, hva som er godt nok. Dataforvalter står for det daglige: oppfølging av kvalitet, vedlikehold av definisjoner og kontrakter. Det tekniske ansvaret for lagring og tilgang i plattformen ligger hos arkitekt og IT. Den vanligste feilen er at dataeier og dataforvalter behandles som synonymer. Da skjer ingenting, fordi alle venter på at noen andre skal bestemme. Og uansett hvem som har rollen: ansvaret må være dokumentert og overførbart. Sitter kunnskapen bare i hodet på én person, har du ikke eierskap. Du har en nøkkelpersonrisiko.
Innfør datakontrakter. Kontrakten gjør eierskap operativt. Den gjør det mulig å håndtere avvik uten at det blir en politisk diskusjon, fordi det står svart på hvitt hva som var avtalt.
Bygg en koordineringsmodell, ikke en ny organisasjon. Du trenger ikke en egen governance-avdeling. Du trenger å vite hvor data behandles i møtene dere har i dag, og hvem som har hvilket ansvar. En RACI-modell lagt oppå eksisterende fora er nok for de fleste. DAMA-DMBOK kaller dette en nettverksmodell: en serie kjente koblinger mellom mennesker og roller.
Følg opp over tid. Datakvalitet er ikke et tall du måler én gang. Det er et løfte mellom produsent og konsument som må holdes. Eieren må se kvaliteten på dataene sine jevnlig, ikke bare når noe har gått galt. Dataforvaltning er heller ikke et prosjekt. Arbeidet har verken start eller slutt, og formaliserer virksomheten forvaltningen, binder den seg for godt. Derfor må rollene sitte hos virksomhetens egne folk fra første dag. En konsulent kan sette opp modellen og kjøre de første rundene, men skylder kunden en plan for hva som skjer den dagen oppdraget er over.
Regn kommunikasjon som hoveddelen av jobben. Bjartes anslag er at femti til sytti prosent av dataforvaltning er kommunikasjon. Du snakker med folk som har helt ulikt utgangspunkt, og det samme budskapet må sies på flere måter før det fester seg. Planlegger du forvaltningen som en teknisk oppgave med litt informasjon på siden, har du snudd forholdet på hodet.
Modenhet: de fem nivåene
Det hjelper å vite hvilket nivå hvert domene er på. Vi bruker en modell i fem nivåer:
| Nivå | Hva det betyr |
|---|---|
| Grunnbehov | Dataene finnes og er tilgjengelige. |
| Stabilitet | Flyten er driftssikker, med versjonskontroll og forutsigbar leveranse. |
| Tillit | Eierskap, kvalitet og kontrakter er på plass. Dataene er til å stole på. |
| Mestring | Brukerne betjener seg selv, fordi definisjoner og tilgang er ryddet. |
| AI og prediktive modeller | Dataene er grunnlaget for avansert analyse i produksjon. |
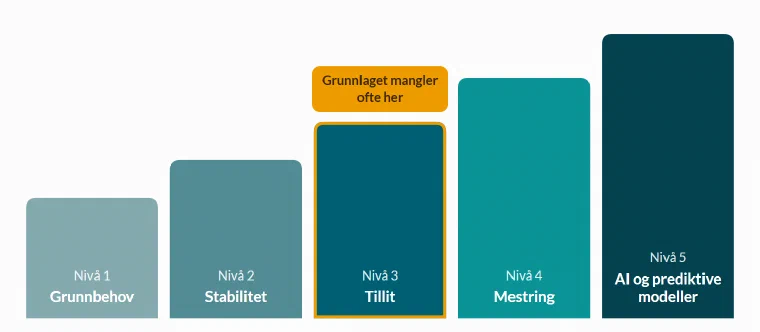
Det vanligste mønsteret vi ser, er at virksomheter driver på nivå fem mens grunnlaget på nivå tre mangler. Avansert analyse kjører i daglig drift, men eierskap, kvalitet og sporbarhet er ikke etablert. Gapet er ikke evnen til å analysere. Det er tilliten. Uten logg, versjonering og sporbarhet kan ingen forklare hvorfor en prognose ble som den ble, og reproduserbarhet er ikke et akademisk krav når modellen styrer reelle beslutninger.
Når det første domenet har en mal og et par dataprodukter på nivå tre, skalerer du gjennom en føderert modell: en sentral funksjon setter felles standarder for kvalitet, sikkerhet og tilgang, mens hvert domene har sine egne eiere som praktiserer standardene lokalt. Sentral styring på prinsippene, lokal ansvarliggjøring på dataene.
Når metoden ikke holder
Å starte med ett domene har en svakhet, og den er verdt å si høyt.
Noen data er tverrgående av natur. Masterdata og referansedata, som kunde, produkt eller organisasjon, brukes overalt og eies ikke naturlig av ett enkelt domene. Hvis du lar hvert domene definere kunde for seg selv, ender du med de samme siloene du prøvde å unngå, bare med tydeligere eierskap inni hver silo.
Konsekvensen er ikke at metoden er feil. Konsekvensen er at de få felles spillereglene må komme parallelt med det første domenet, ikke etterpå. Du starter lite på domener, men du utsetter ikke en felles datakontrakt-mal, en delt begrepsbruk for de mest sentrale begrepene, og en avklaring av hvem som eier masterdataene. Start lite på utførelsen, ikke på prinsippene.
Det er også verdt å si: ikke alle trenger full desentralisering. For en mindre virksomhet kan en lettere modell holde lenge. Metoden her handler om rekkefølge og momentum, ikke om å kopiere en arkitektur fra et stort teknologiselskap.
God praksis peker samme vei
Det er lett å påstå at «start lite» er riktig. De etablerte rammeverkene peker samme vei, hver fra sitt ståsted.
DAMA-DMBOK, bransjens standardverk for dataforvaltning, er tydelig: «Rarely is DG deployed enterprise-wide as a first effort.» De fleste utrullinger er inkrementelle. Boken løfter fram prinsippet «evolution not revolution», og beskriver nettverksmodellen med RACI som det naturlige første steget før man eventuelt formaliserer mer. Den fødererte modellen beskrives som en sentralisert strategi med desentralisert utførelse, og for store virksomheter ofte den eneste som virker.
Data mesh, formulert av Zhamak Dehghani, gjør domeneorientert og desentralisert dataeierskap til et bærende prinsipp, med domenets bounded context som grensen for eierskap, og dataproduktet som leveransen. Vår erfaring er at en trinnvis innføring slår en stor omlegging. De som annonserer at «nå gjør vi data mesh» og strukturerer om alt på en gang, ender ofte med verken fordelene ved desentralisering eller klarheten ved sentral kontroll. Vi anbefaler derfor å starte med ett eller to domener som har klare grenser, kompetente folk og et reelt problem eierskap kan løse.
Det er den samme oppskriften vi bruker. Ikke fordi den står i en bok, men fordi den virker.
En tommelfingerregel
Hvis du ikke kan navngi én person som har mest å tape på at et bestemt datasett er feil, har du ikke et domene ennå. Du har en hypotese. Og det er helt greit å starte der.
Slik kommer du i gang:
- Velg det ene domenet der grensene er klare, eieren er villig og problemet er ekte.
- Bygg ett eller to kritiske dataprodukter, og lag malen mens du gjør det.
- Hold tooling enkel til behovet vokser, og etabler de få felles spillereglene fra start.
- Skriv naboene ned som hypoteser. Så utvider du.
Får du jobben og hundre dager på deg, er de tre kravene planen, men formålet kommer først. Finn det ene problemet virksomheten alt vet at den har, og vær sikker på at du har valgt riktig før du går videre. Bruk neste periode på mandatet, altså på å plassere det formelle eierskapet hos noen med reell myndighet. Løs så kapasiteten ved å finne folk som får satt av tid. Kjøp ikke verktøy, og skriv ikke policyer og et stort rammeverk. Grunnprinsippene for rollene er nok til at alle vet hvem som er hvem, og da har du kommet langt på hundre dager.
Hva ville vært det første domenet hos dere?
Ofte stilte spørsmål
Hva er dataforvaltning? Dataforvaltning, på engelsk data governance, er rammeverket for hvordan en virksomhet styrer dataene sine: hvem som eier dem, hvilke regler som gjelder for kvalitet, tilgang og bruk, og hvem som har ansvar når noe er feil. Dataeierskap er den operative kjernen som gjør rammeverket virkelig.
Hva er en dataeier? En dataeier er en leder med reell myndighet i forretningsområdet dataene hører til. Eieren bestemmer hvordan dataene tolkes, hvem som har tilgang, og hva som er god nok kvalitet. Det skal ikke være en IT-rolle.
Hva er forskjellen på et datasett og et dataprodukt? Forvaltning. Et datasett er bare data. Et dataprodukt har en eier, et tydelig formål, en datakontrakt og en kvalitet det står inne for.
Hva er grunndata? Grunndata er master- og referansedata: kjerneenhetene og kodene hele virksomheten deler, som kunde, produkt og leverandør, og kodeverk for land og valuta. De eies ikke naturlig av ett domene og krever felles definisjoner på tvers.
Hvor begynner man med dataforvaltning? Med ett domene og én eier. Velg området der grensene er klare, eieren er villig, og dårlige data koster penger i dag. Bygg ett eller to kritiske dataprodukter der, lag malen mens du gjør det, og utvid derfra.
Trenger vi data mesh for å komme i gang? Nei. Prinsippene fra data mesh, domeneeierskap og data som produkt, er nyttige uansett størrelse. Men full desentralisering er ikke et mål i seg selv. Mindre virksomheter klarer seg lenge med en lettere modell.
Lær mer
Relatert lesning på glitni.no:
Kilder og videre lesning:
- Datautforskerne, episode 20: Dataforvaltning med Bjarte Tolleshaug, 2. november 2026
- DAMA International, Data Management Body of Knowledge (DAMA-DMBOK), 2. utgave, 2017
- Zhamak Dehghani, Data Mesh Principles and Logical Architecture, martinfowler.com, 3. desember 2020
- Eric Evans, Domain-Driven Design, Addison-Wesley, 2003
- Andrew Jones, Driving Data Quality with Data Contracts, Packt, 2023
- Bitol, Open Data Contract Standard (ODCS), versjon 3.2.0, 8. september 2026
Hør hele samtalen med Bjarte Tolleshaug
Hør på podkasten «Datautforskerne», episode 20, der Bjarte Tolleshaug og Magne Bakkeli snakker om hvorfor dataeierskap ikke virker uten mandat, formål og kapasitet, og hva du bør gjøre de første hundre dagene. Episoden er tilgjengelig på Spotify, Apple og Acast. I episode 19 snakket vi om hvor gode dataene må være.
Magne Bakkeli er medgründer og seniorrådgiver i Glitni. Han har over 25 års erfaring med dataplattformer, data governance og dataarkitektur, og ledet Data & Analytics-teamet i PwC Consulting i 12 år. Han har bygget og modernisert dataplattformer i kraft, FMCG, finans og media.