
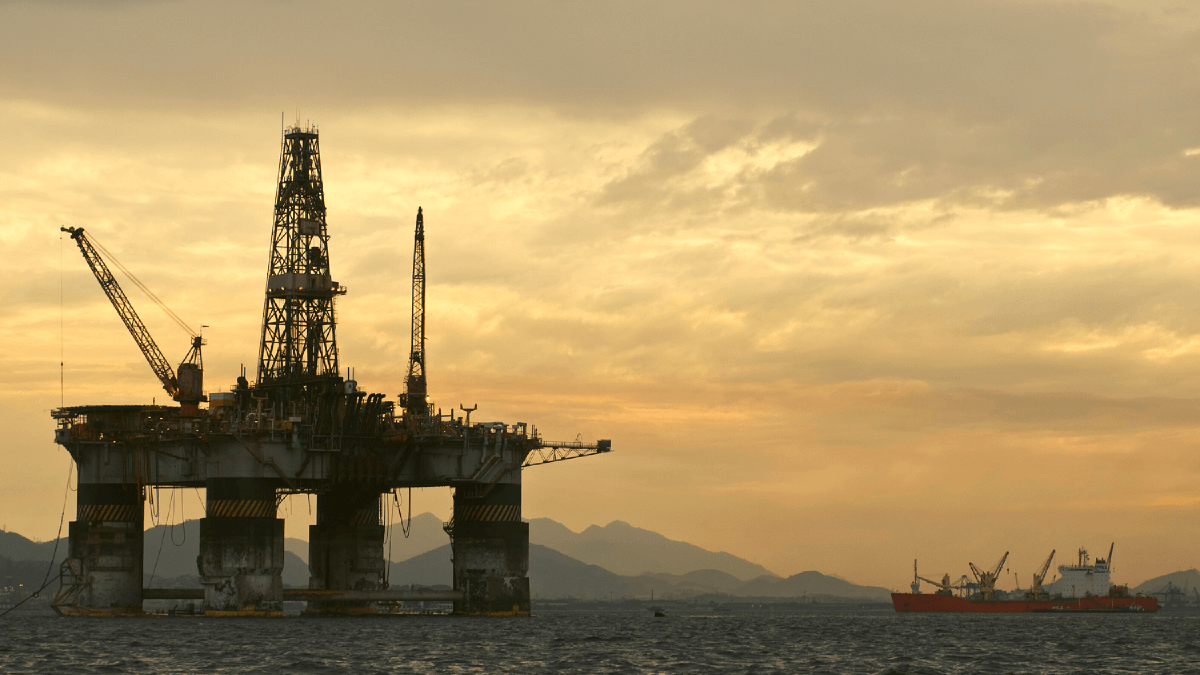
Et datavarehus samler data fra mange kildesystemer i én felles, modellert struktur, slik at tallene kan sammenlignes på tvers av systemene og over tid. Det tar vare på historikken som fagsystemene ofte ikke tar vare på selv, og er grunnlaget for rapporter, dashboards og analyser. I dag er det også laget AI-agenter må bruke for å svare riktig på spørsmål om virksomhetens tall.
Mange regner datavarehuset som gammel teknologi, forbigått av data lake og lakehouse. Datavarehuset har riktignok flyttet inn i skyen og deler i dag tabeller med lakehouse, men oppgaven er den samme som før: å gi virksomheten ett sted der tallene er definert, kontrollert og til å stole på. Med AI-agenter som nye brukere har den oppgaven blitt viktigere.
«A warehouse is a subject-oriented, integrated, time-variant and non-volatile collection of data in support of management’s decision making process»
Bill Inmon, ofte omtalt som grunnleggeren av datavarehuset, i boka Building the Data Warehouse (1992)
Datavarehuset kan bygges på ulike prinsipper
I noen virksomheter skal datavarehuset ta vare på hele organisasjonens kunnskap i én felles modell, uten å starte i et bestemt analytisk behov. Det er Inmon-modellen. Andre virksomheter bygger mer målrettede datavarehus for et bestemt formål, for eksempel kundefrafallsanalyse, prosjektrapportering eller lønnsomhet (ABC), og binder dem sammen med felles dimensjoner. Det er Kimball-modellen, og de målrettede delene kalles ofte data marts.
Den tredje måten er Data Vault, som Dan Linstedt utviklet. Modellen skiller forretningsnøklene (hubs) fra relasjonene mellom dem (links) og fra de beskrivende opplysningene med historikk (satellites), slik Linstedt og Michael Olschimke beskriver det. Den tåler at kildene endrer seg, og gjør det lett å spore et tall tilbake til kilden. Derfor velges den ofte der kildesystemene er mange og kravene til sporbarhet høye. Data Vault brukes gjerne som den felles modellen i midten, med stjerneskjemaer på toppen for rapportering.
Vanligvis inneholder datavarehuset sammenstilte data fra mange kildesystemer, og en viktig oppgave er å sikre god nok datakvalitet til at analyser og rapporter får et pålitelig underlag. Datavarehus inneholder ofte både rådataene og de ferdig transformerte dataene i en felles datamodell. Mange fagsystemer tar ikke vare på historikk, og da er det ofte datavarehuset som gjør det. God historikk er en forutsetning for å finne trender og bygge prognoser og scenarier.
Datavarehuset har ett eller flere lag med data som er bearbeidet og lagret i en felles datamodell, og på toppen data som er bearbeidet og lagret for ulike formål. Vi lagrer altså data minst to ganger, både i rådatalaget og i den felles datamodellen. Dobbeltlagringen gir økt kostnad, men god ytelse for brukerne når data skal hentes ut. Lagene svarer i grove trekk til bronse, sølv og gull i medallion-arkitekturen som Databricks har gjort kjent.
Hvordan ser et datavarehus ut i skyen?
Tidligere kjørte de fleste datavarehus på egne servere med en relasjonsdatabase eller en spesialisert databasemaskin, og kapasiteten måtte kjøpes på forhånd. I prosjektene vi i Glitni er med på, bygges nye datavarehus i dag nesten alltid på en skytjeneste som Snowflake, Google BigQuery, Databricks, Amazon Redshift eller Microsoft Fabric. Tre ting er annerledes:
Lagring og beregning er skilt. Dataene ligger ett sted, og flere beregningsklynger kan lese dem samtidig uten å gå i veien for hverandre. Snowflake beskriver arkitekturen som ett sentralt lager med «virtuelle varehus» som skaleres hver for seg. Dere betaler for lagringen og for beregningen dere bruker.
Rådataene lastes inn før de transformeres. Med ELT (extract, load, transform) havner kildedataene urørt i varehuset, og transformasjonene skjer der, ofte med dbt. Det gjør det lettere å rette en feil og bygge modellen på nytt, fordi rådataene alltid ligger der.
Grensen mot lakehouse er visket ut. Snowflake har siden juni 2024 kunnet lese og skrive tabeller i det åpne formatet Apache Iceberg i kundens egen skylagring, og Fabric Warehouse lagrer alle data som Delta-tabeller i det samme lageret som Fabric Lakehouse. Varehus og lakehouse kan dermed lese de samme tabellene.
Skyvarehusene håndterer også semistrukturerte data som JSON direkte, gjennom kolonnetypen VARIANT i Snowflake og JSON-typen i BigQuery. Valget står derfor sjeldnere mellom datavarehus og lakehouse, og oftere om hvor den felles modellen og styringen av dataene skal ligge. Les mer i kapitlet om data lakehouse.
Hva brukes et datavarehus til?
Datavarehus brukes ofte til detaljerte rapporter basert på strukturerte data av høy kvalitet. Ledere, forretningsanalytikere og operative brukere bruker dem når de trenger data som raskt kan svare på vanlige forretningsspørsmål, eller som grunnlag for faste rapporter og dashboards. Dataene er godt strukturerte, lette å forstå og enkle å ta i bruk uten videre behandling. De kommer gjerne fra forretningssystemer som mange bruker, som økonomi- eller CRM-systemet.
Noen eksempler fra ulike bransjer:
- Detaljhandel: salgstrender over tid, sesongvariasjoner i etterspørselen og lagerbeholdning tilpasset forventet salg.
- Bank og finans: kundeporteføljer, transaksjonshistorikk for å oppdage mistenkelig aktivitet og kredittrisiko basert på historiske data.
- Helse: pasientforløp, kapasitet og ressursbruk på tvers av avdelinger.
Hva er data marts, eller datatorg på norsk?
Når det snakkes om datavarehus, kan du høre begrepet data mart, eller datatorg på norsk. Et data mart er en undergruppe av et datavarehus som er rettet mot ett forretningsområde eller ett tema. Markedsavdelingen bruker for eksempel ofte et data mart for kundedata, fordi de trenger rask tilgang til standardiserte kundedata.
Data marts bygges vanligvis som en utvidelse av et eksisterende datavarehus, men de kan også bygges som en selvstendig enhet. Prosessen følger hvordan datavarehus blir til, men med et mer spesialisert sluttresultat.
Datamodellering i et datavarehus
Dataene i et datavarehus er modellerte og klare til bruk. Datamodellering handler om å bestemme hvordan dataene skal lagres, organiseres og gjøres tilgjengelige, slik at analyser og rapporter blir enkle å lage og gir samme svar hver gang. Datamodellen beskriver hvilke data som finnes, hvordan de henger sammen og hvordan de skal brukes.
Dimensjonstabeller og faktatabeller er sentrale begreper. Dimensjonstabellene er det som gir tallene kontekst (for eksempel «Kalender» eller «Lokasjon»), mens faktatabellene inneholder selve nøkkeltallene (for eksempel «Omsetning»). Med faktatabellen i midten og dimensjonene rundt blir det et stjerneskjema, som Ralph Kimball gjorde kjent i boka The Data Warehouse Toolkit.
Datavarehuset og AI
AI-agenter er blitt en ny brukergruppe for datavarehuset. De svarer på spørsmål om virksomhetens tall, og de stiller strengere krav enn en analytiker gjør. En erfaren analytiker vet hvilken tabell som er den riktige, mens agenten må finne det ut selv.
Anthropic, selskapet bak Claude, beskrev i juni 2026 hvordan de bruker Claude til analyse internt. De oppgir at Claude besvarer 95 prosent av forretningsanalysespørsmålene deres, med rundt 95 prosent riktige svar samlet, målt med deres egne tester. Det viktigste for treffsikkerheten er ifølge dem datafundamentet: datamodellene, transformasjonene, testene og tabellene i datavarehuset, med beskrivelser. Dimensjonell modellering er like viktig som før, skriver de.
Hos Anthropic bommet agenten oftest fordi den ikke klarte å koble et begrep som «omsetning for produkt X» til den ene riktige tabellen, når flere tabeller lignet. Løsningen deres er færre datasett med tydelige eiere og én definisjon per begrep. Det er den samme jobben et godt datavarehus alltid har gjort.
En agent blir ikke bedre enn datamodellen og definisjonene den bruker, og det har vi skrevet mer om i artikkelen om harness og kontekst for datateam.
Datavarehusets fordeler og ulemper
Nedenfor oppsummerer vi noen viktige fordeler og ulemper ved å bruke et datavarehus til rapportering og analyse:
| Fordeler |
|---|
|
| Ulemper |
|---|
|
Vanlige spørsmål om datavarehus
Hva er forskjellen på et datavarehus og en database? En database lagrer transaksjonene i ett system, som et CRM- eller økonomisystem. Et datavarehus henter data fra mange slike systemer, samler dem i én modell og tar vare på historikken, slik at tallene kan analyseres på tvers av systemene og over tid.
Hva er forskjellen på et datavarehus og en data lake? Et datavarehus lagrer strukturerte data som er modellert og klare til bruk. En data lake lagrer alle typer data i råformat, også dokumenter og bilder, og dataene modelleres først når de skal brukes. Et data lakehouse kombinerer de to.
Er datavarehuset utdatert? Nei. Datavarehuset har flyttet inn i skyen og deler i dag tabeller med lakehouse gjennom åpne formater som Apache Iceberg og Delta Lake. Behovet for ett modellert og kontrollert lag har blitt større med AI-agenter som brukere.
Trenger AI-agenter et datavarehus? Ja, hvis de skal svare på spørsmål om virksomhetens tall. Da trenger de modellerte data med én definisjon per begrep. Ellers velger de mellom tabeller som ligner hverandre, og svarer feil.
Lær mer
De andre kapitlene i guiden:
- Hva er en dataplattform?: oversikten over lagringsformene og hva en dataplattform bidrar med.
- Hva er en database?: når en vanlig database er nok.
- Hva er en data lake?: lagring av alle datatyper i råformat.
- Hva er et data lakehouse?: datavarehus og data lake i samme arkitektur.
- Historisk utvikling: hvordan dataplattformene har utviklet seg.
Vi har også skrevet om komponentene i en dataplattform, som viser hvordan delene virker sammen fra kilde til bruk.
Kilder:
- Building the Data Warehouse (Bill Inmon, Wiley, 4. utgave 2005, første utgave 1992): definisjonen av datavarehuset.
- Star schemas (Kimball Group, lest 8. november 2026): stjerneskjemaet med fakta og dimensjoner.
- Building a Scalable Data Warehouse with Data Vault 2.0 (Dan Linstedt og Michael Olschimke, Morgan Kaufmann, 2015): Data Vault med hubs, links og satellites.
- What is a medallion architecture? (Databricks, lest 8. november 2026): bronse-, sølv- og gull-lagene.
- Snowflake key concepts and architecture (Snowflake, lest 8. november 2026): skillet mellom lagring og beregning.
- Iceberg tables: General Availability (Snowflake, 10. juni 2024): Iceberg-tabeller i Snowflake.
- Store data in Microsoft Fabric (Microsoft, lest 8. november 2026): Fabric Warehouse på Delta-tabeller i OneLake.
- How Anthropic enables self-service data analytics with Claude (Anthropic, juni 2026): erfaringene med analyseagenter.
Hvordan Glitni kan hjelpe
Glitni bygger og forvalter data- og AI-plattformer, og bistår som data engineers med å tilrettelegge data for analyse og agenter. Vi hjelper med datamodellering, valg av plattform og flytting av datavarehus til skyen. Les mer om data engineering og dataarkitektur.
Har dere et datavarehus som skal moderniseres, eller AI-agenter som skal bruke det? Send oss en melding for en prat.
Magne Bakkeli er medgründer og seniorrådgiver i Glitni. Han har over 25 års erfaring med dataplattformer, data governance og dataarkitektur, og ledet Data & Analytics-teamet i PwC Consulting i 12 år. Han har bygget og modernisert dataplattformer i kraft, FMCG, finans og media.