
Innhold
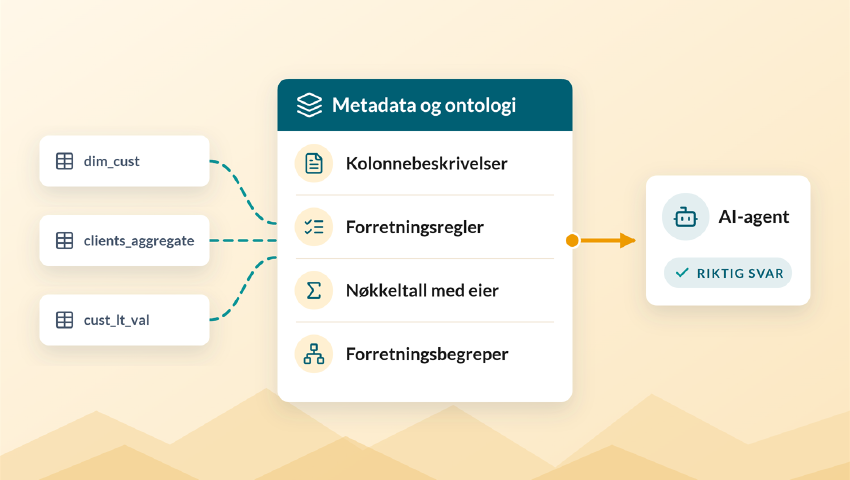
Metadata og ontologi har blitt fundamentet AI leser fra

Kategori: Data Governance | Emneknagger: #metadata, #ontologi, #semantisk lag, #kontekstlag, #kunnskapsgraf, #ai-agenter
En AI-agent med tilgang til tabellene svarte riktig på 0 av 13 spørsmål. Da teamet la på kontekst rundt dataene, ett lag om gangen, svarte den samme modellen riktig på 92 prosent.
Sist oppdatert: oktober 2026.
Kort fortalt: En AI-agent som skal svare på spørsmål om virksomhetens egne data, trenger mer enn bare tilgang til tabellene. Målingene fra 2026 viser at modellene skriver bedre SQL for hvert år, men at de riktige svarene kommer når kolonnene har beskrivelser, forretningsreglene er skrevet ned og nøkkeltallene har en eier. Metadata, semantisk lag og ontologi er ord for deler av det samme laget, og laget kan bygges steg for steg uten et eget ontologiprosjekt.
En AI-agent hos en medisinsk klinikk fikk spørsmål om hvor mange ledige timer klinikken hadde. Den skrev en spørring som filtrerte på slot_status = 'Available', men den verdien finnes ikke i dataene, for kolonnen bruker Open og Filled. Spørringen kjørte, returnerte null rader og ga ingen feilmelding. Agenten svarte selvsikkert – og helt feil.
Eksemplet kommer fra et forsøk hos analyseselskapet Data Culture, der Opeyemi Fabiyi og kollegene målte hva som skulle til før agenten svarte riktig. Feilen forsvant ikke med en ny modell eller en bedre instruks. Den forsvant da kolonnene fikk beskrivelser som sa hvilke verdier de kan ha, og hva verdiene betyr.
Modellene har blitt mye bedre det siste året, og det betyr noe. Men det siste stykket mot riktige svar på egne data kommer fra laget rundt dataene, altså beskrivelsene, forretningsreglene, nøkkeltallene med en eier og koblingen mellom tabellene og forretningsbegrepene. Laget kalles metadata, semantisk lag, kontekstlag eller ontologi, avhengig av hvem du spør, og denne artikkelen handler om hva det består av, og hvordan dere bygger det.
Hva viser målingene?
Tre uavhengige målinger peker samme vei. Kontekst rundt dataene øker andelen riktige svar mer enn et bytte av modell, og forretningsreglene gir den største forbedringen. Bedre modeller har nesten doblet presisjonen fra tekst til SQL siden 2023, men modellen kan ikke vite det som ikke står skrevet ned noe sted.
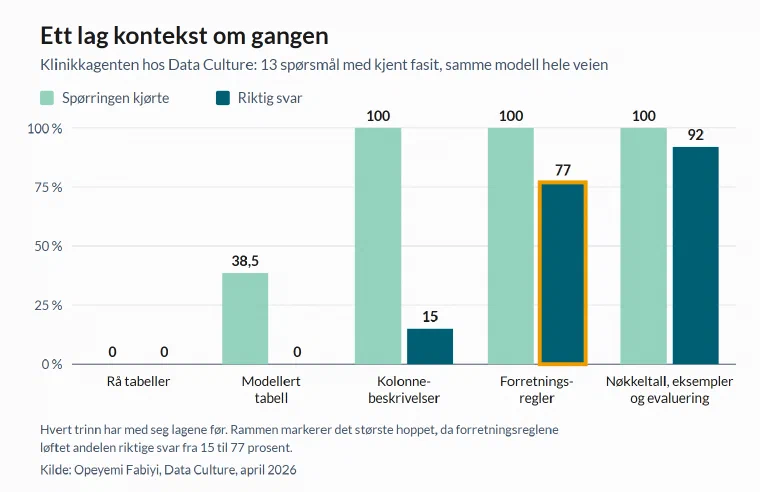
Fabiyi og kollegene bygde agenten for klinikken og stilte den 13 forretningsspørsmål med kjent fasit. De la på ett lag kontekst om gangen og målte to ting etter hvert lag: om agenten skrev en spørring som kjørte, og om svaret var riktig.
Med rå tabeller klarte agenten ingenting. Med en modellert tabell skrev den spørringer som kjørte, på 38,5 prosent av spørsmålene, men ingen av svarene var riktige. Den brukte feil statusfelt, tok med interne oppføringer og visste ikke hvilke rader som skulle holdes utenfor. Med kolonnebeskrivelser kjørte alle spørringene, og 15 prosent av svarene var riktige. Fabiyi kaller beskrivelsene det enkeltlaget som betyr mest, og det var de som fikk alle spørringene til å kjøre. Det største hoppet i riktige svar kom likevel da forretningsreglene ble skrevet inn, fra 15 til 77 prosent. Med definerte nøkkeltall, verifiserte eksempelspørringer og en fast evaluering endte agenten på 92 prosent. Om 92 prosent er godt nok, er et annet spørsmål.
Samme team gjorde et parallelt forsøk på data fra en butikk, der agenten skrev spørringer som kjørte på 80 prosent av spørsmålene med bare den modellerte tabellen. Fabiyi skriver at jo mer spesialisert fagfeltet er, desto viktigere blir beskrivelsene. Underveis fant teamet også at noen svar som var vurdert som feil, var riktige, bare formatert annerledes enn fasiten, og rettet evalueringen. Det er et poeng i seg selv – for uten et evalueringssett vet ingen om laget virker.
Resultatet stemmer med en eldre måling. Juan Sequeda, Dean Allemang og Bryon Jacob ved data.world stilte i 2023 GPT-4 spørsmål om en database fra forsikring, uten eksempler i instruksen. Rett mot SQL-databasen svarte modellen riktig på 16 prosent av spørsmålene. Med en kunnskapsgraf som beskrev begrepene og koblingene mellom dem, svarte den riktig på 54 prosent.
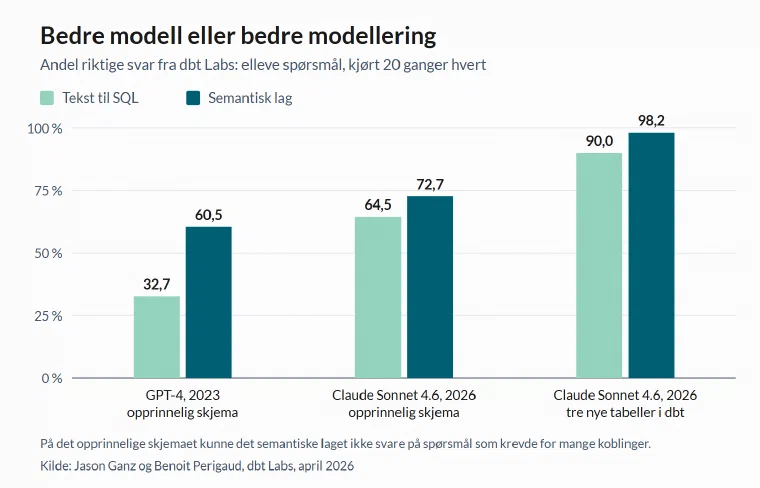
dbt Labs har stilt de samme elleve spørsmålene til modeller fra 2023 og 2026, 20 ganger hvert. Med GPT-4 i 2023 ga tekst til SQL riktig svar i 32,7 prosent av tilfellene. Med Claude Sonnet 4.6 og GPT-5.3 Codex i 2026 kom begge på 64,5 prosent. Så modellerte teamet tre nye tabeller i dbt. Tekst til SQL med Sonnet 4.6 steg til 90,0 prosent, og svarene gjennom det semantiske laget steg til 98,2 prosent. Det semantiske laget svarte riktig hver gang på spørsmålene det dekket, men kunne bare svare på det som var modellert. Presisjonen kostet dekning.
Heller ikke de største miljøene klarer seg uten. OpenAI beskrev i januar dataagenten de bruker internt, over mer enn 600 petabyte og rundt 70 000 datasett. Agenten bygger på seks lag kontekst: hvordan tabellene brukes, merknader fra folk som kjenner dataene, beskrivelser laget med Codex, kunnskap fra organisasjonen, minne fra tidligere spørsmål og kontekst mens agenten kjører. Uten kontekst kan selv sterke modeller gi feil svar, skriver de.
Modellvalget betyr altså noe, og forskjellen fra 2023 er stor. Men når modellen bare får tabellene, uten modellering eller beskrivelser, kommer ingen av målingene over 65 prosent riktige svar.
Hva er forskjellen på metadata, semantisk lag, ontologi og kunnskapsgraf?
Metadata beskriver dataene, et semantisk lag definerer nøkkeltallene, en ontologi beskriver begrepene i forretningen og hvordan de henger sammen, og en kunnskapsgraf er data lagret etter en ontologi. Grensene er flytende, og leverandørene bruker ordene ulikt, så spør hva laget lover før dere velger.
| Begrep | Hva det beskriver | Spørsmålet det svarer på | Eksempel |
|---|---|---|---|
| Teknisk metadata | Tabeller, kolonner, datatyper, eier og opphav | Hva finnes, og hvor kommer det fra? | slot_status er tekst med verdiene Open og Filled |
| Forretningsordliste | Definisjonen av hvert forretningsbegrep | Hva betyr ordet hos oss? | En ledig time er en time med status Open, der vi kan ta imot pasienter for legekonsultasjon |
| Semantisk lag | Nøkkeltall, dimensjoner og koblinger over tabellene | Hvordan regnes tallet ut? | Kapasitetsutnyttelse er fylte timer delt på alle timer |
| Ontologi | Begrepene, relasjonene mellom dem og reglene som gjelder | Hvordan henger tingene sammen? | Bare bedriftskunder kan ha salgskontrakter |
| Kunnskapsgraf | Data lagret som noder og kanter etter en ontologi | Hvilke ting er koblet til hverandre? | Kunde 123 har salgskontrakt 456 |
Ordet ontologi er det mest forvirrende. Massimiliano Geraci skrev i juli at det nå brukes om tre ting med hver sin mening. Den opprinnelige betydningen er en formell modell i RDF eller OWL, med klasser, egenskaper og regler, og en motor som kan resonnere seg fram til det ingen har skrevet ned. Den andre er en virtuell modell på toppen av SQL, der begrepene kobles til tabellene som alt finnes i dataplattformen. Den tredje er et styrt lag for nøkkeltall, definert én gang og brukt av BI-verktøy og agenter, og det er denne de store plattformene nesten alltid mener når de sier semantikk. Den første lover at maskinen kan utlede nye fakta, mens den tredje lover at tallet blir det samme uansett hvor noen spør. Geraci skriver at automatisk generering av ontologier gikk fra forskningsdemo til en avkrysningsboks på hver store dataplattform på rundt tolv måneder, og han leser spriket i betydningene som et kart over hvor vekten flytter seg.
Under støyen ligger et godt poeng. Juha Korpela, som skriver om modellering i nyhetsbrevet Context and Chaos fra Atlan, skiller mellom to plan. Dataplanet er de tekniske objektene, som tabeller, skjemaer og felt, spredt over flere plattformer. Kunnskapsplanet er meningen, altså begrepene, definisjonene og relasjonene mellom dem. Tabellen dim_cust i ett skjema og clients_aggregate i et annet kan handle om de samme kundene, men ingenting i tabellene sier det. Kunnskapsplanet kan si at virksomheten har kunder av to typer, bedriftskunder og privatkunder, at bare bedriftskundene kan ha salgskontrakter, og at begge kan legge inn ordre.
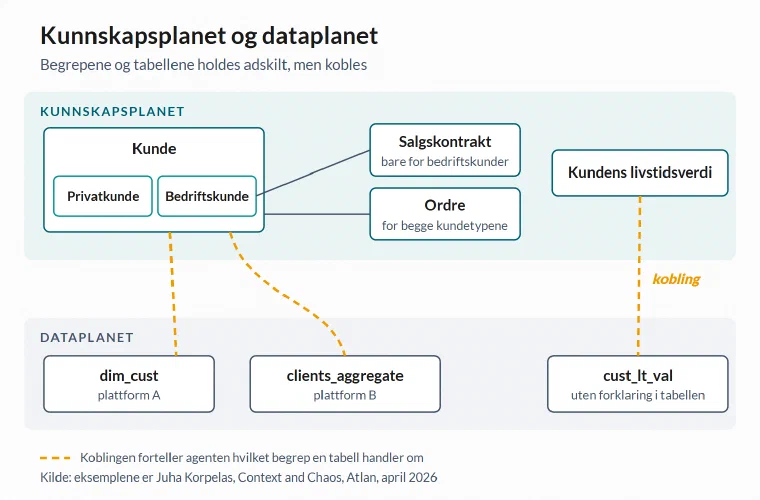
Korpela skriver at de to planene må holdes adskilt og kobles, for det er koblingen som forteller en agent hva cust_lt_val betyr. Uten kunnskapsplanet gjetter agenten ut fra hvordan ting vanligvis er. Det går ofte bra for det generelle, og feiler på det som er spesielt for virksomheten, som gjerne er det mest verdifulle. Den andre feilen han beskriver, er semantiske siloer, der hver løsning får sine egne definisjoner, og ingen av dem stemmer med hverandre på tvers.
Hvorfor har metadata blitt viktigere med AI?
Før AI var metadata dokumentasjon for folk, og en beskrivelse som manglet, gjorde lite skade. En agent leser beskrivelsene som instrukser, og der en beskrivelse mangler, fyller den inn sin egen antakelse. Derfor må eierskap, sensitivitet og tillatt bruk nå være beskrevet slik at en maskin kan lese det uten å misforstå.
I den gamle verdenen var metadata noe pliktoppfyllende team fylte ut i etterkant. Eierfelt, en merking av sensitivitet, kanskje en beskrivelse ingen leste. AI har snudd det på hodet.
McKinsey skriver i sin gjennomgang av AI data readiness at metadata må bli kontroll-laget for ustrukturert innhold. Autonome systemer bruker kontekstsignaler til å avgjøre hva som kan brukes og hvordan det skal tolkes. Eierskap, sensitivitet og tillatt bruk må være tydelig angitt for hvert uttrekk, ikke bare for kildedokumentasjonen. Metadata er ikke lenger et arkiv. Det er instruksjonene AI leser før den svarer.
David Effiong i Data Culture skriver at foreldet dokumentasjon bare forvirrer et menneske litt, mens den for et AI-system blir feil resonnering i stor skala og uten at noen ser det. Hvilke typer metadata som finnes, og hva de er verdt, har Martin Sahlen skrevet om i gjesteinnlegget Verdien av metadata.
Den kjedeligste jobben i faget, å skrive ned hva en kolonne betyr, har blitt en av de viktigste.
Hva trenger en AI-agent som BI ikke trengte?
En rapport i et BI-verktøy trenger å vite hva et nøkkeltall er og hvordan det regnes ut. En agent som skal forklare tallet, trenger også å vite når definisjonen endret seg, hvilke kvalitetsproblemer som fantes i perioden, og hva tallet ikke må forveksles med. Uten det svarer agenten likevel, bare ikke nødvendigvis riktig.
Effiong deler det i to. Det første er henting, altså om systemet finner riktig tall på riktig sted, og der er de fleste moderne dataplattformer gode. Det andre er resonnering, altså om systemet vet hva tallet betyr, når det kan stoles på, og hva det ikke må blandes sammen med. Det er dette de færreste har bygget.
Et system kan hente churn_rate for forrige kvartal uten problemer. Skal det svare på hvorfor kundefrafallet steg, trenger det definisjonen, om definisjonen nettopp er endret, kjente kvalitetsproblemer i perioden og forhold utenfor dataene.
Effiong skriver at et semantisk lag bygget for BI og et bygget for AI ikke er det samme, selv om de ser like ut i YAML. Laget for AI trenger i tillegg relasjonene mellom nøkkeltallene og de vanlige forvekslingene, merking av når definisjonene endret seg, kjente kvalitetsproblemer per periode og forretningsreglene som lever i hodene til analytikerne. Han kaller laget en kontrakt mellom teamet og agenten. Det er samme tanke som datakontrakter, bare med en ny mottaker som tar alt bokstavelig.
Artyom Keydunov, medgründer og daglig leder i Cube, skriver at en agent som må gjette definisjonene ut fra kolonnenavn, gjerne lager femten versjoner av «aktiv kunde».
I hvilken rekkefølge bygger dere laget?
Start med et sett spørsmål med kjent fasit, og legg på ett lag om gangen mens dere måler. Rekkefølgen under følger målingene fra Data Culture, og legger til eierskap og koblingen til forretningsbegrepene, som de andre kildene peker på. Hvert steg gjør dataene lettere å bruke for folk også.
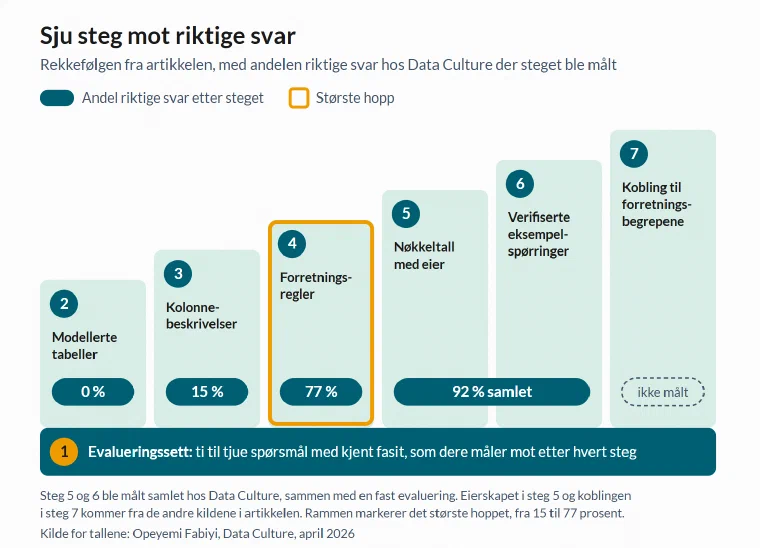
- Evalueringssett: Velg ti til tjue spørsmål forretningsbrukerne stiller, med svar dere vet er riktige. Uten fasit vet dere ikke om neste lag hjelper, og dere oppdager ikke at fasiten selv kan være feil.
- Modellerte tabeller: En agent som leser rå tabeller, klarer ingenting. Tabeller som speiler forretningen, med tydelige navn, er gulvet, og datamodellering er håndverket som lager dem.
- Kolonnebeskrivelser: Beskriv hver kolonne med verdiene den kan ha og hva verdiene betyr. Det var dette som fikk klinikkagenten til å slutte å lete etter Available.
- Forretningsregler: Skriv ned hvilke rader som skal holdes utenfor, hvilke statuser som teller, og hva som er internt. Denne kunnskapen finnes bare i hodene, og den ga det største hoppet.
- Nøkkeltall med eier: Definer nøkkeltallene én gang, og gi hvert av dem en forretningseier, slik vi beskriver i artikkelen om dataeierskap.
- Verifiserte eksempelspørringer: Legg inn spørringer dere vet gir riktig svar, for spørsmålene som går igjen.
- Kobling til forretningsbegrepene: Knytt tabellene til begrepene i forretningsordlista eller ontologien, så samme begrep betyr det samme på tvers av løsninger.
Eieren i steg 5 er ikke en formalitet. Ella Pham skrev i 2024 at et semantisk lag uten eiere av nøkkeltallene virker mot sin hensikt. Brukerne diskuterer fortsatt hva tallene betyr, men kan ikke lenger rette dem selv.
Dette er ikke et ontologiprosjekt. Korpela skriver at en modell av virksomheten ikke trenger å være et dokumentasjonsarbeid over flere år, men kan vokse fram fra kunnskapen som finnes. Thiago Baldim beskriver det samme fra SafetyCulture. Der var ikke AI i BI hovedmålet, men noe som var fint å ha. Teamet ryddet i datamodellen, testene, dokumentasjonen og eierskapet, og kjøretiden på de samme dataene falt fra 14 til 1,5 timer. Da agenten kom på toppen, skyldtes de første feilene kolonner som var udokumentert eller feil dokumentert. Etter en måned hadde analytikerne 90 prosent færre forespørsler om enkeltuttrekk, og nesten halvparten av virksomheten stilte spørsmål til dataene med AI hver dag.
Hva gjør leverandørene?
Alle de store dataplattformene har lansert et semantisk lag eller en ontologi det siste året. For en virksomhet betyr det at definisjonene kan ligge nær dataene, men også at de kan bli låst i ett verktøy hvis ingen passer på hvor de står.
Snowflake gjorde Semantic View Autopilot, som lager utkast til semantiske visninger, allment tilgjengelig i februar 2026. Databricks gjorde forretningssemantikken i Unity Catalog allment tilgjengelig og til åpen kildekode i april, med metric views for nøkkeltallene. Microsoft har en ontologi i Fabric IQ i forhåndsversjon, som beskriver forretningsbegrepene og kobler dem til dataene i Fabric.
Mer interessant enn enkeltproduktene er arbeidet med en åpen standard. Apache Ossie, som het Open Semantic Interchange til prosjektet ble tatt opp i Apache-inkubatoren i juni 2026, skal gjøre definisjonene leverandørnøytrale. Da endrer spørsmålet seg fra hvilken leverandørs semantiske lag dere velger, til hvilke definisjoner som kan flyttes mellom dem. I teorien i hvert fall. Da vi testet standarden på interndagen vår i oktober 2026, fant vi at den i dag er mest nyttig som et kart over definisjonene du alt har, ikke som en felles motor som får alle verktøyene til å regne likt.
Hva vi i Glitni ser
Mønsteret går igjen i prosjektene vi er inne i. Verdien ligger sjelden i en ny modell eller en ny plattform, men i det klassiske arbeidet med å skrive ned hva kolonnene betyr, kode forretningsreglene som bare finnes i hodene til folk, gi nøkkeltallene en eier og gjøre koblingen mellom data og forretningsbegreper tydelig.
En kunde som betaler oss for å skrive gode kolonnebeskrivelser og en ryddig semantisk modell, investerer mer i AI enn en som kjøper nok en integrasjon med en språkmodell. Det høres nesten skuffende ut, men det er dit målingene peker, fra 92 prosent hos Data Culture til 98,2 prosent hos dbt Labs.
Arbeidet lønner seg uansett. Et ryddig kunnskapsplan gir raskere svar, færre omkamper om tall og et grunnlag folk stoler på, med eller uten en agent på toppen. AI er bare grunnen til at mange virksomheter endelig prioriterer det.
En test
Spør AI-agenten, eller BI-verktøyet, hva «aktiv kunde» betyr hos dere. Sammenlign svaret med det økonomi mener, og det salg mener. Spriker de tre svarene, har dere ikke et modellproblem. Dere har et ontologiproblem, og det løser ingen ny plattform for dere.
Hvor mange versjoner av det viktigste begrepet deres er i bruk akkurat nå?
Vanlige spørsmål om metadata og ontologi for AI
Hvorfor gir en AI-agent feil svar på egne data? Fordi den mangler konteksten folk har i hodet: hva kolonnene og verdiene betyr, hvilke regler som gjelder, og hvordan nøkkeltallene regnes ut. Agenten gjetter da ut fra navn og allmennkunnskap, og en spørring kan kjøre uten feil og likevel gi feil svar. I forsøket til Data Culture løftet kolonnebeskrivelser og forretningsregler andelen riktige svar fra null til 77 prosent, med samme modell.
Hva er forskjellen på metadata, semantisk lag og ontologi? Metadata beskriver dataene, som tabeller, kolonner, eier og opphav. Et semantisk lag definerer nøkkeltallene og hvordan de regnes ut. En ontologi beskriver begrepene i forretningen og hvordan de henger sammen, og en kunnskapsgraf er data lagret etter en ontologi. Leverandørene bruker ordene ulikt, så spør hva laget lover før dere velger.
Trenger vi et eget ontologiprosjekt? Sjelden. Modellen av begrepene kan vokse fram av arbeidet med datamodellering, dokumentasjon og eierskap. Start med et evalueringssett, beskriv kolonnene og skriv ned forretningsreglene, og legg til koblingen til forretningsbegrepene der samme begrep brukes i flere løsninger.
Hjelper det å bytte til en bedre språkmodell? Noe. dbt Labs målte at tekst til SQL nesten doblet presisjonen fra GPT-4 i 2023 til modellene fra 2026, fra 32,7 til 64,5 prosent. Da tre nye tabeller ble modellert i dbt, steg den til 90 prosent, og gjennom det semantiske laget til 98,2 prosent. Konteksten ga mer enn modellbyttet.
I hvilken rekkefølge bygger vi laget? Evalueringssett, modellerte tabeller, kolonnebeskrivelser, forretningsregler, nøkkeltall med eier, verifiserte eksempelspørringer og koblingen til forretningsbegrepene. Mål etter hvert steg mot evalueringssettet, så dere ser hva hvert lag gir.
Kilder
- Opeyemi Fabiyi: The Boring Work That Makes AI Analytics Actually Work, Data Culture, 28. april 2026. Figur 1 bygger på tallene herfra.
- David Effiong: Analytics Engineering for AI Projects: Context as Infrastructure, Data Culture, 21. april 2026.
- Jason Ganz og Benoit Perigaud: Semantic Layer vs. Text-to-SQL: 2026 Benchmark Update, dbt Labs, 7. april 2026. Figur 2 bygger på tallene herfra.
- Juan Sequeda, Dean Allemang og Bryon Jacob: A Benchmark to Understand the Role of Knowledge Graphs on Large Language Model’s Accuracy for Question Answering on Enterprise SQL Databases, arXiv, november 2023.
- Bonnie Xu, Aravind Suresh og Emma Tang: Inside OpenAI’s in-house data agent, OpenAI, 29. januar 2026.
- Massimiliano Geraci: Everybody Ships an Ontology Now. Nobody Agrees What the Word Means., LinkedIn, 1. juli 2026.
- Juha Korpela: Conceptual Modeling Is the Context Engineering Nobody Is Doing, Context and Chaos, Atlan, 15. april 2026. Eksemplene i figur 3 er hans.
- McKinsey: gjennomgangen av AI data readiness, 23. juni 2026.
- Thiago Baldim: The journey to Agentic BI, Medium, 15. april 2026.
- Artyom Keydunov: Building BI for Agents, Cube, 30. juni 2026.
- Ella Pham: #30 - The why, how and what of semantic layer, Data & Beyond, 9. juni 2024.
- Snowflake: Semantic View Autopilot, 3. februar 2026, og dokumentasjonen for semantiske visninger.
- Databricks: Unity Catalog Business Semantics: Now GA and Open Source, 2. april 2026, og dokumentasjonen for metric views.
- Microsoft: Ontology i Fabric IQ, dokumentasjon, lest 9. oktober 2026.